Modelos e fornecedores
Cada agente de programação do Bromure Agentic Coding — Claude Code, Codex, Grok, Kimi e omp — obtém o seu modelo e as suas credenciais de um único sítio: o quadro Modelos. Regista cada fonte uma vez (o início de sessão ou a chave de API de um fornecedor de nuvem, o Amazon Bedrock, o OpenRouter, um servidor de inferência seu, ou modelos que correm neste Mac), e todas as máquinas a podem usar. Uma máquina (um espaço de trabalho, no editor de definições) herda estas definições globais por predefinição e pode substituir qualquer parte delas.
Este capítulo trata do próprio quadro, do início e fim de sessão, da escolha de modelos por agente, das substituições por máquina, de como os agentes chegam a fornecedores que não são os seus, do que acontece aos agentes em execução quando muda alguma coisa, e do motor integrado no dispositivo: o seu catálogo, os descarregamentos, as janelas de monitorização e os comandos model. Para a lista campo a campo do painel do espaço de trabalho, consulte Definições de modelos. O Fusion — vários modelos a responder ao mesmo prompt — é uma funcionalidade à parte, com o seu próprio painel.
Nota: As versões anteriores tinham um painel Agentes por espaço de trabalho, um painel Modelos locais e um modo de encaminhamento «híbrido» que passava da nuvem para um modelo local. Os três desapareceram. As escolhas de modelos e credenciais vivem no quadro Modelos, e o tráfego de uma máquina vai para a nuvem ou para um motor local, agente a agente, como se descreve abaixo.
Onde aparece o quadro Modelos
O mesmo quadro de duas colunas aparece em quatro sítios:
| Onde | O que edita | Quando as alterações se aplicam |
|---|---|---|
| Preferências › Modelos (⌘,) | As definições globais que todas as máquinas herdam. | De imediato — o quadro guarda à medida que edita, independentemente do botão Guardar da janela de Preferências. |
| O editor de definições de uma máquina › Modelos | A substituição das definições globais própria dessa máquina (consulte Substituições por máquina). | Quando clica em Guardar no editor. |
| O passo Modelos do assistente de boas-vindas | As definições globais, só na primeira execução. | De imediato. |
| As Preferências de um Mac remoto espelhado (Configurações para: um anfitrião remoto) | As definições globais desse Mac, obtidas pelo túnel com as chaves de API ocultadas. | Quando clica em Guardar. Consulte Acesso remoto. |
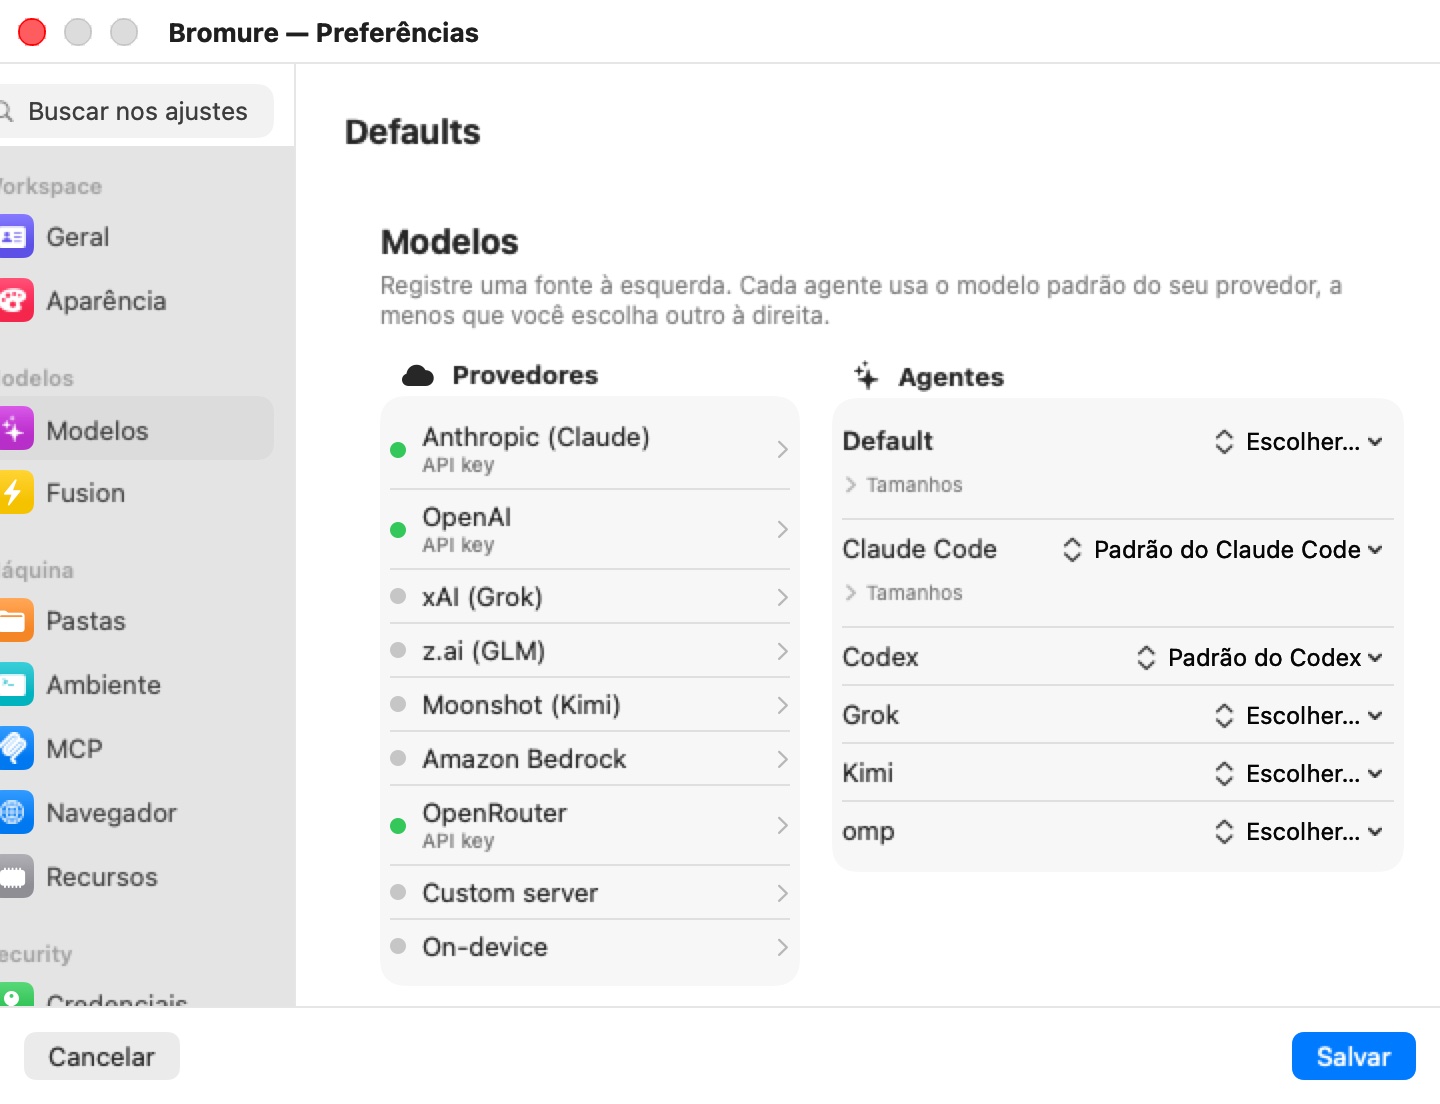
O painel tem o título Modelos, com a legenda «Registre uma fonte à esquerda. Cada agente usa o modelo padrão do seu provedor, a menos que você escolha outro à direita.» À esquerda fica a coluna Provedores; à direita, a coluna Agentes.
Fornecedores
Cada linha de Provedores tem um ponto de estado e um subtítulo de uma linha. Verde significa utilizável; cinzento, não configurado; laranja, um início de sessão de subscrição expirado. Clique numa linha para abrir a sua janela instantânea de configuração.
| Fornecedor | Como o configurar | Notas |
|---|---|---|
| Anthropic (Claude) | Início de sessão por subscrição ou chave de API | Fornecedor nativo do Claude Code. |
| OpenAI | Início de sessão por subscrição ou chave de API | Fornecedor nativo do Codex. |
| xAI (Grok) | Início de sessão por subscrição ou chave de API | Fornecedor nativo do Grok. |
| z.ai (GLM) | Só chave de API | O plano de programação da z.ai é entregue como chave de API; não há nada onde iniciar sessão. |
| Moonshot (Kimi) | Início de sessão por subscrição ou chave de API | Fornecedor nativo do Kimi. |
| Amazon Bedrock | Usar Amazon Bedrock, região opcional e chave de API opcional | Consulte Amazon Bedrock. |
| OpenRouter | Só chave de API | A sua lista de modelos é obtida em direto do OpenRouter. |
| Servidor personalizado | URL do servidor e chave de API opcional | Qualquer servidor compatível com OpenAI. Consulte Servidor personalizado. |
| No dispositivo | Descarregar modelos | Os modelos MLX correm na GPU deste Mac. Consulte Modelos no dispositivo. |
O subtítulo da linha diz como um fornecedor está configurado: API key, subscription, login expirado, Credenciais AWS (Bedrock), um nome de anfitrião (servidor personalizado) ou N installed (no dispositivo). Na substituição de uma máquina, também pode dizer inherited API key, inherited subscription, overridden here ou off here.
Início de sessão e chaves de API
Para a Anthropic, a OpenAI, a xAI e a Moonshot, a janela instantânea começa com Sign in with fornecedor («Login interativo em uma VM temporária — sem necessidade de chave de API.»), e depois «ou cole uma chave de API» por cima de um campo Chave de API. Sem nenhum dos dois, diz Ainda não configurado.
O início de sessão executa o login da CLI do próprio fornecedor dentro de uma VM descartável; a página do fornecedor abre no seu navegador, e o início de sessão capturado é guardado no anfitrião, nunca numa máquina. Com a sessão iniciada, a janela instantânea mostra Sessão iniciada com há quanto tempo, e ainda Entrar novamente… e Sair…. Sair… pede confirmação — «Sair de fornecedor?», «Os workspaces que usam este login deixam de funcionar até você entrar novamente.» — com Sair / Cancelar.
Se o fornecedor rejeitar um início de sessão guardado (por exemplo, porque foi revogado noutro lado), a janela instantânea passa para um painel laranja Login expirado que explica que as sessões não o podem usar até iniciar sessão de novo, com um botão Entrar novamente em destaque.
Uma chave de API colada tem prioridade sobre uma subscrição do mesmo fornecedor: escrever uma chave passa esse fornecedor para pagamento por utilização. As chaves são guardadas encriptadas (consulte Onde as definições são guardadas).
Nota: Uma subscrição só pode alimentar o seu próprio agente — uma subscrição Claude move o Claude Code, uma subscrição ChatGPT move o Codex, e assim por diante. Por isso, um fornecedor com sessão iniciada por subscrição nunca aparece no menu de modelos de outro agente e não pode ser usado na linha Default. As chaves de API não têm essa restrição.
Âmbito da subscrição: todas as máquinas ou só uma
Um início de sessão feito em Preferências › Modelos é sempre partilhado por todas as máquinas. Um início de sessão feito no editor de definições de uma máquina (o seu painel Modelos) termina com uma pergunta: Compartilhar com todos os espaços de trabalho? — «Usar este login fornecedor para todos os espaços de trabalho do Bromure (substituindo o login fornecedor próprio de cada um), ou só para este?» — com Todos os espaços de trabalho e Apenas este espaço de trabalho.
- Todos os espaços de trabalho guarda o início de sessão como o partilhado e remove qualquer início de sessão específico de uma máquina para esse fornecedor, para que o novo seja mesmo o que todas as máquinas usam.
- Apenas este espaço de trabalho guarda-o só para essa máquina. Uma máquina com início de sessão próprio usa-o sempre em vez do partilhado.
Quando o início de sessão foi feito a partir de um Mac remoto espelhado e ninguém responde à pergunta, a escolha por predefinição é Apenas este espaço de trabalho.
Amazon Bedrock
A janela instantânea do Bedrock explica: «Qualquer agente pode correr no Amazon Bedrock: o Claude Code nativamente, os outros através da API compatível com OpenAI do Bedrock. Assine os pedidos com as credenciais AWS de cada espaço de trabalho (Credenciais → AWS), ou cole uma chave de API do Bedrock.»
- Ative Usar Amazon Bedrock.
- Opcionalmente, defina a Região da AWS. Se ficar vazia, cada máquina usa a região das suas próprias credenciais AWS, ou então
us-east-1. - Opcionalmente, cole uma Chave de API do Bedrock (opcional — senão as credenciais da AWS assinam). Sem chave, o anfitrião assina cada pedido com as credenciais AWS da máquina, do seu painel Credenciais; as credenciais nunca entram na VM.
Ativar o Bedrock preenche o modelo principal do Claude Code com um ID de modelo Claude do Bedrock. Os IDs de modelos são os que o Bedrock usa (por exemplo us.anthropic.claude-sonnet-4-6); escolha-os por agente no menu ou escreva os seus com ID personalizado…. O Bedrock não tem um endpoint que liste os modelos, por isso o menu oferece uma lista curta selecionada.
Um agente no Bedrock sem chave de API só está pronto a arrancar em máquinas que tenham credenciais AWS. Desligar Usar Amazon Bedrock limpa todas as escolhas de modelos que apontavam para o Bedrock, e esses agentes voltam às suas predefinições.
Servidor personalizado
Um Servidor personalizado é qualquer servidor de inferência compatível com OpenAI — vLLM, Ollama, LM Studio, llama-server — neste Mac ou noutro ponto da sua rede. A janela instantânea descreve-o como «Recommended for local models.»
- Ative Ativado.
- Introduza o URL do servidor (por exemplo
http://127.0.0.1:11434/v1) e, se o servidor precisar, uma Chave de API (opcional). - Clique em Testar conexão. Em caso de sucesso, mostra N model(s) e os modelos do servidor aparecem no menu de cada agente em Servidor personalizado; em caso de falha, mostra o erro do servidor.
Com um servidor personalizado, o ID do modelo é o do próprio servidor, tal como está (por exemplo qwen3:32b). O proxy de reparação do anfitrião traduz o formato de transmissão de cada agente (mensagens Anthropic, chat OpenAI, responses OpenAI) para o /v1/chat/completions do servidor e de volta, e a janela de contexto do modelo, o suporte a visão e o raciocínio são sondados no servidor e passados aos agentes. Nenhum processo de motor é iniciado no Mac para um servidor personalizado.
Modelos no dispositivo
No dispositivo abre uma lista de modelos do catálogo — «MLX models run in-process on this Mac (N GB) — the lazy backup, nothing to install.» Cada linha mostra o nome do modelo, um emblema de adequação (Fits, Tight ou Won't fit) e o tamanho do descarregamento, e uma ação:
| Controlo | Significado |
|---|---|
| Obter | Descarrega o modelo. Desativado quando não cabe neste Mac. |
| Barra de progresso + ✕ | A descarregar; ✕ cancela e elimina o descarregamento parcial. |
| Retomar | Um descarregamento interrompido (a aplicação saiu ou falhou); continua onde parou. |
| Tentar novamente | O descarregamento falhou; passe o cursor por cima para ver o motivo. |
| Remover | Instalado; remove os pesos e limpa qualquer escolha de modelo que os usasse. |
Os modelos instalados aparecem no menu de cada agente em No dispositivo. Os descarregamentos são partilhados por todas as máquinas. O catálogo, as regras de adequação e o motor são descritos em O motor no dispositivo.
Agentes: escolher modelos
A coluna Agentes tem uma linha Default e depois uma linha por agente: Claude Code, Codex, Grok, Kimi e omp. Cada linha tem uma pastilha de modelo; clique nela para escolher.
O que uma pastilha mostra:
- Agente default — nada está escolhido e o fornecedor próprio do agente está configurado, por isso o agente usa o modelo predefinido desse fornecedor, exatamente como faria o seu próprio «Default» de
/model. Não precisa de escolher nada. - Escolher… — nada está escolhido e nada se resolve para este agente.
- Um ID de modelo, com um ponto colorido para a sua origem (azul: um fornecedor de nuvem; menta: o servidor personalizado; roxo: no dispositivo; laranja, riscado e marcado · indisponível: um fornecedor que este agente não consegue alcançar — consulte Que agente alcança que fornecedor). · herdado depois do ID significa que o valor vem da linha Default (ou, numa substituição de máquina, das definições globais). Um ✕ ao lado de uma escolha explícita limpa-a.
O menu da pastilha lista cada fornecedor utilizável que o agente consegue alcançar como submenu de IDs de modelos (uma lista selecionada, combinada com a lista de modelos em direto do fornecedor quando existe), seguido de Servidor personalizado e No dispositivo quando configurados. Cada submenu de fornecedor termina com ID personalizado…, que pede «The id exactly as the backend names it (e.g. claude-opus-5, glm-4.6, qwen3-coder).» Para um agente com uma escolha explícita, o menu também oferece Usar padrão (ou Use agent’s default quando nada está definido na linha Default) para a limpar.
Se o menu não tiver nada a oferecer, di-lo: Configure um provedor primeiro; No configured provider can power agent quando os fornecedores configurados estão todos fora do alcance desse agente; ou Uma assinatura só pode alimentar o próprio agente quando os únicos fornecedores configurados são subscrições de outros agentes. Em Servidor personalizado, Teste a conexão para listar os modelos significa que o servidor ainda não foi sondado.
A linha Default
Um modelo na linha Default aplica-se a todos os agentes que não têm escolha própria — incluindo os agentes cujo fornecedor próprio está configurado e que, caso contrário, usariam o modelo predefinido do seu fornecedor. Deixe Default em Escolher… se quiser cada agente no modelo predefinido do seu próprio fornecedor.
Tamanhos
O Claude Code usa três posições de modelo; todos os outros agentes usam um só modelo. As linhas Default e Claude Code têm uma secção Tamanhos com duas pastilhas extra:
| Tamanho | Posição do Claude Code |
|---|---|
| Large | ≈ opus |
| (pastilha principal) | ≈ sonnet |
| Small | ≈ haiku (tarefas de fundo e rápidas) |
Sem definição, as posições grande e pequena seguem as predefinições do próprio Claude Code. Tamanhos abre-se sozinha quando uma delas está definida. Na linha Claude Code, Restaurar padrão descarta todas as escolhas próprias do Claude Code, para que volte a herdar da linha Default. O Codex, o Grok, o Kimi e o omp só usam a pastilha principal.
Que agente alcança que fornecedor
Cada agente alcança nativamente o seu próprio fornecedor. Também pode ser apontado para alguns outros fornecedores, que o anfitrião faz a ponte por ele:
| Agente | Fornecedor nativo | Também alcança |
|---|---|---|
| Claude Code | Anthropic (subscrição ou chave) | Amazon Bedrock (o modo Bedrock próprio do Claude Code); OpenRouter e z.ai (diretamente, pelos seus endpoints compatíveis com Anthropic, chave de API); servidor personalizado; no dispositivo |
| Codex | OpenAI | Amazon Bedrock, OpenRouter, xAI, Moonshot (pelo proxy de reparação do anfitrião, chave de API); servidor personalizado; no dispositivo |
| Grok | xAI | Amazon Bedrock, OpenRouter, Moonshot (proxy de reparação); servidor personalizado; no dispositivo |
| Kimi | Moonshot | Amazon Bedrock, OpenRouter, xAI (proxy de reparação); servidor personalizado; no dispositivo |
| omp | Anthropic, só chave de API | Amazon Bedrock, OpenRouter, xAI, Moonshot (proxy de reparação); z.ai quando o próprio omp é mudado para lá; servidor personalizado; no dispositivo |
Na rota do proxy de reparação, o agente dentro da VM fala com o anfitrião, que traduz o formato de transmissão do agente, guarda a chave real (ou assina para o Bedrock) e reencaminha o pedido. A chave nunca entra na VM. As rotas OpenRouter e z.ai do Claude Code apontam antes o agente diretamente para o endpoint compatível com Anthropic do fornecedor (https://openrouter.ai/api, https://api.z.ai/api/anthropic), com uma chave substituta que o anfitrião troca pela real na transmissão, como faz para qualquer credencial de nuvem (consulte Credenciais e a fronteira de transmissão).
O menu de modelos de um agente só oferece os fornecedores que ele consegue alcançar. O Claude Code só fala o dialeto Anthropic, por isso o seu menu não tem modelos OpenAI, xAI nem Moonshot; a API compatível com OpenAI da z.ai não é uma para a qual os outros agentes possam ter ponte, por isso o menu do Claude Code é o único menu de agente que oferece modelos z.ai (o omp mudado para a z.ai chega lá por si).
Uma escolha guardada antes de deixar de ser alcançável — ou herdada da linha Default por um agente que não a pode usar — aparece a laranja, riscada, seguida de · indisponível. A dica explica: «Agent can’t use provider models, so it runs on its own provider instead. Pick another model.»
O omp não tem fornecedor próprio no quadro e não pode usar subscrições; dê-lhe um fornecedor baseado em chave de API.
Substituições por máquina
O editor de definições de uma máquina tem um painel Modelos (no grupo Modelos). Por predefinição mostra um interruptor, Ajustes de modelos personalizados para este workspace, desligado — «Inheriting the global settings (Preferences → Models).» — e um resumo Modelos herdados: os modelos globais Large / Medium / Small e os fornecedores configurados.
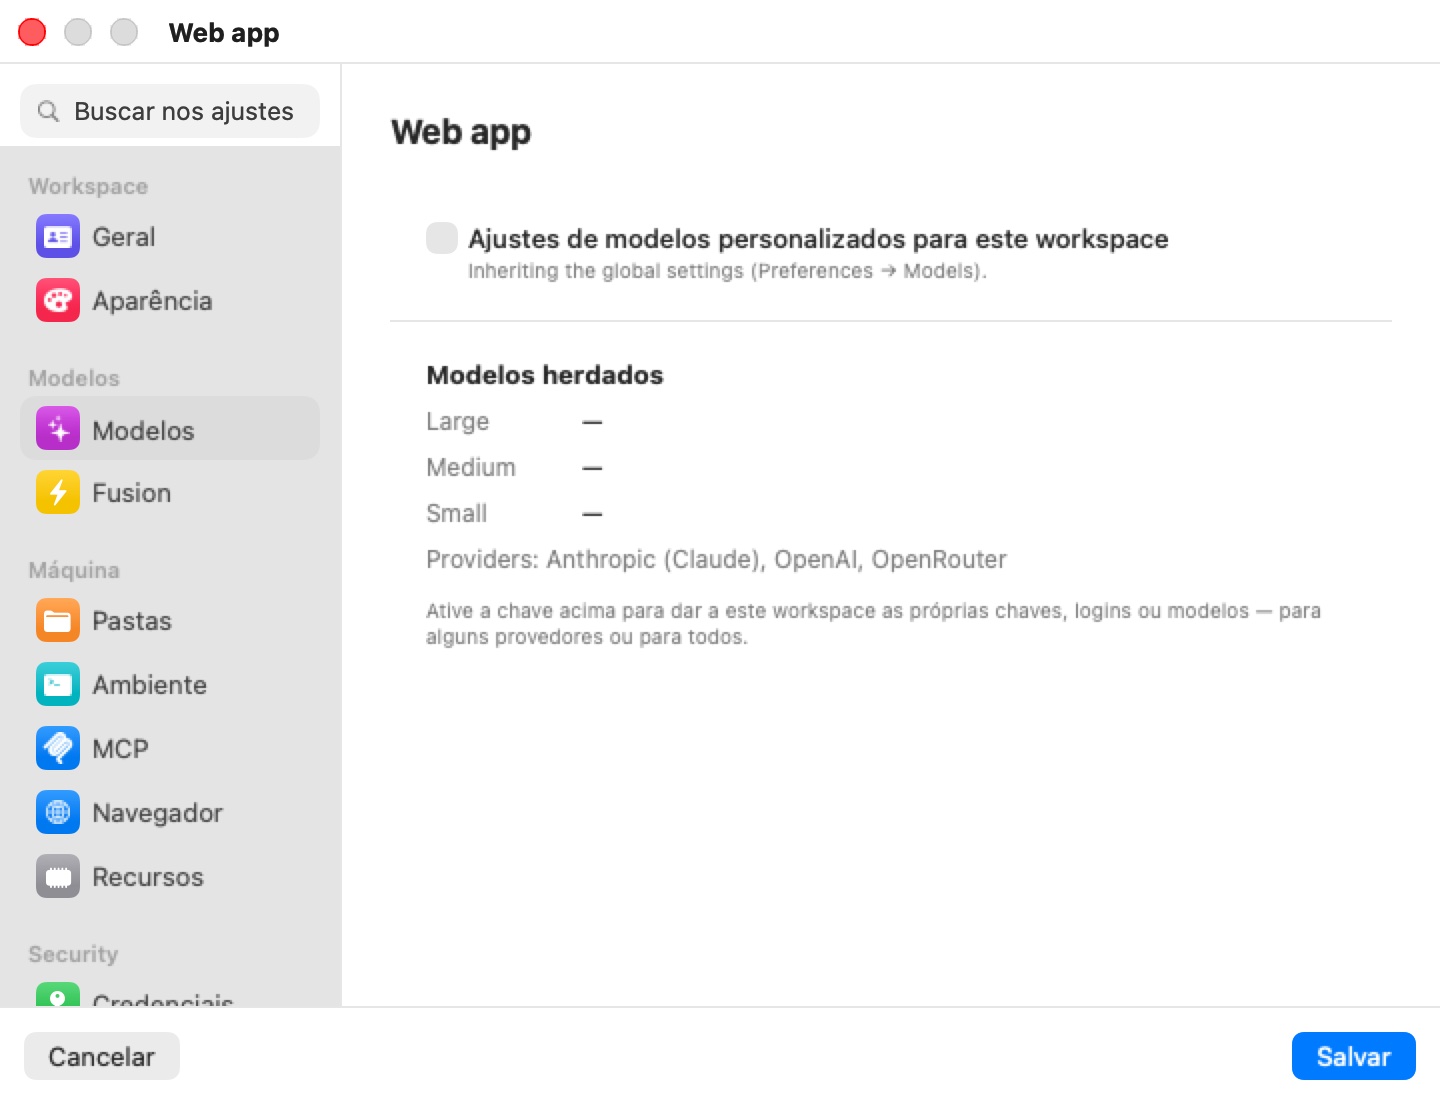
Ligue o interruptor e escolha um de dois modos:
- Herdar, com alterações (a predefinição) — «Starts from the global settings; only what you set below is different here.» Aparece o quadro completo, com as definições globais e as alterações desta máquina por cima. Tudo o que não tocar continua a seguir as definições globais em direto — um fornecedor que registe globalmente mais tarde também aparece aqui.
- Independente — «This workspace has its own providers, logins and model choices below — the global settings are ignored.» Passar para Independente parte de uma cópia do que está em vigor, por isso nada muda até editar.
No modo Herdar, com alterações, cada janela instantânea de fornecedor diz de onde vem o fornecedor e permite mudar isso só para esta máquina:
| Rótulo | Significado |
|---|---|
| Inherited from Preferences → Models (API key / subscription / AWS credentials). | É usada a credencial global. Não usar neste workspace exclui-a, «— or override it below» com a chave ou o início de sessão próprio desta máquina. |
| Not used in this workspace — the global settings have it. | Excluiu-a. Usar o provedor global volta a incluí-la. |
| This workspace's own credential. | Esta máquina tem a sua própria chave ou início de sessão. Usar o provedor global descarta-a. |
| This workspace's own server. / Usar o servidor global | O mesmo para o servidor personalizado. |
As pastilhas de modelos funcionam como no quadro global; uma pastilha inalterada mostra · herdado, e limpar uma escolha explícita devolve-a ao valor global (Usar a configuração global).
A substituição é guardada com a máquina quando clica em Guardar. As chaves escritas numa substituição são guardadas encriptadas com os outros segredos da máquina.
Mudar de modelo em máquinas em execução
Nunca precisa de reiniciar uma máquina por causa de uma mudança de modelo ou de credencial. Quando regista um fornecedor, cola ou altera uma chave, inicia ou termina sessão, muda um agente para outro modelo, ou guarda a substituição de uma máquina:
- O anfitrião atualiza o que os agentes da máquina leem — o mapa de troca de credenciais, o ambiente e os ficheiros de configuração dos agentes — em todas as máquinas em execução.
- Cada agente cujas credenciais ou modelo mudaram de facto é parado no seu separador e relançado de imediato com as opções de retoma, por isso a conversa continua. Na vista de chat, a sessão mantém a transcrição; num terminal, vê o agente sair e voltar logo a seguir.
- Os agentes cuja configuração não mudou ficam como estão, e a própria VM nunca reinicia.
- A configuração Fusion da máquina segue as mesmas definições: os seus ramos e o juiz são reavaliados, e o interruptor ⚡ é desligado se restarem menos de dois modelos utilizáveis.
As alterações no quadro global aplicam-se cerca de um segundo e meio depois de parar de escrever.
Aviso: Reiniciar um agente interrompe o que ele estava a fazer nesse momento. Se um agente estiver a meio de um turno longo, espere que termine antes de mudar o seu modelo ou as suas credenciais.
Onde as definições são guardadas
As definições globais ficam em ~/Library/Application Support/BromureAC/models.enc, encriptadas com a mesma chave que o cofre de segredos dos espaços de trabalho. A substituição de uma máquina é guardada com a máquina, com as suas chaves no repositório de segredos encriptado. Os inícios de sessão das subscrições ficam no anfitrião, no proxy de credenciais, partilhados ou por máquina conforme escolhido acima. Nenhum destes segredos é alguma vez copiado para uma VM: os agentes recebem valores substitutos que o anfitrião troca na transmissão.
Limites
- As subscrições só estão disponíveis para Anthropic, OpenAI, xAI e Moonshot, e cada uma só alimenta o seu próprio agente.
- O omp só usa chaves de API.
- Um servidor personalizado tem de ser compatível com OpenAI.
- Dentro de uma máquina, todos os agentes que correm localmente (servidor personalizado ou no dispositivo) partilham um único modelo local: prevalece a escolha do agente principal.
- O motor no dispositivo usa a única GPU do Mac e executa uma geração de cada vez.
- O quadro Modelos não está disponível no Bromure Remote para iPhone, iPad ou Apple Vision Pro; edite os modelos a partir de um Mac.
O motor no dispositivo
O motor no dispositivo executa modelos de programação de pesos abertos na GPU do seu Mac com a framework MLX da Apple — sem ida e volta à nuvem, sem fatura por token e sem código a sair do Mac. Não há nada para instalar, nenhum ambiente Python nem servidor para configurar.
Nota: A inferência corre no Mac, não dentro da VM. O dispositivo gráfico Metal opcional do navegador não dá ao Linux computação GPU nem acesso ao MLX, por isso o convidado chega ao motor atravessando a fronteira de transmissão. É necessário Apple Silicon — o mesmo requisito da própria aplicação.
O processo do motor
O motor MLX corre como processo filho supervisionado do próprio binário da aplicação (bromure-ac model _mlx-engine), não dentro da aplicação. Carregar um modelo grande demais para a memória do Mac mata só o processo filho do motor, nunca a aplicação nem as suas VMs em execução. A aplicação reinicia automaticamente um motor que falhou, até três vezes; depois disso desiste, com a linha de registo engine child crashed repeatedly — giving up (a model likely OOMs this Mac). O processo filho é terminado quando a aplicação sai, e um órfão deixado por uma falha grave é recolhido no arranque seguinte.
Um só motor serve todas as máquinas. Liga-se a uma porta de loopback atribuída pelo kernel em 127.0.0.1 — nunca 0.0.0.0, e nunca a 11434 habitual do Ollama, para que uma instalação separada de Ollama ou LM Studio continue a funcionar. Pode manter vários modelos dentro de um orçamento de memória (a memória unificada do Mac menos alguma margem), carregando cada um na primeira utilização e expulsando o menos usado recentemente quando a memória aperta.
Enquanto o motor aquece, a barra de ferramentas de uma máquina mostra um pequeno emblema de CPU com um indicador de atividade («Starting local engine…»); fica verde quando o modelo está pronto, ou laranja se o motor não conseguiu arrancar (passe o cursor por cima para ver o motivo).
Como o convidado lá chega
Os agentes na VM nunca falam diretamente com o motor. Apontam para o anfitrião sintético https://bromure.llm, que não tem DNS real: o proxy do lado do anfitrião interceta-o, aplica a mesma análise de injeção de prompt e a mesma captura de rastreio que ao tráfego de nuvem, e reencaminha o pedido para o motor. A inferência local nunca é um ponto cego.
Os agentes são configurados com o ID de modelo real que o motor serve (por exemplo mlx-community/Qwen3-8B-4bit-DWQ), para que o dimensionamento do contexto e as consultas de capacidades vejam a verdade.
Nota: Um modelo cuja arquitetura o motor MLX ainda não suporta falha com um erro claro e permanente — «its architecture … isn't supported by the on-device engine yet — pick a different model» — devolvido como erro de cliente para que o agente não o repita em ciclo. Use um servidor personalizado para esses modelos.
O catálogo
O catálogo é uma lista selecionada de modelos MLX pré-convertidos, cada um verificado quanto ao que mais importa na programação agêntica — chamadas de ferramentas fiáveis — e cada um com um tamanho de descarregamento e uma quantidade mínima de memória unificada.
Um catálogo de base vem dentro da aplicação, para que a lista funcione offline desde o primeiro dia. A aplicação obtém um catálogo atualizado em https://dl.bromure.io/mlx/catalog.json; um catálogo publicado mais recente substitui o de base em vez de se juntar a ele. Um modelo retirado do catálogo publicado desaparece da lista, a menos que já o tenha instalado.
O catálogo incluído tem quatro modelos Qwen3, todos verificados para chamadas de ferramentas:
| Modelo | Descarregamento | Memória unificada mínima | Recomendado |
|---|---|---|---|
| Qwen3 8B (4-bit DWQ MLX) | 4.3 GB | 16 GB | Sim |
| Qwen3-Coder 30B-A3B (4-bit DWQ MLX) | 17 GB | 32 GB | Sim |
| Qwen3-Coder-Next 80B-A3B (mxfp4 MLX) | 42 GB | 96 GB | Sim |
| Qwen3-Coder 480B-A35B (4-bit MLX) | 270 GB | 512 GB | Não |
Um catálogo atualizado pode acrescentar versões mais recentes ou maiores sem uma atualização da aplicação.
O emblema de adequação
Cada modelo é avaliado em relação à memória unificada do seu Mac:
- Won't fit — o mínimo do modelo excede a sua memória. A linha fica esbatida e não pode ser descarregada.
- Tight — carrega, com menos de 16 GB de sobra para tudo o resto.
- Fits — o mínimo mais 16 GB de margem cabe.
Por exemplo, o Qwen3 8B (mínimo de 16 GB) mostra Tight num Mac de 16 GB e Fits a partir de 32 GB.
Descarregamentos e armazenamento
Os pesos vêm diretamente de huggingface.co através de um descarregador integrado — sem Python e sem conversão. Cada ficheiro de pesos é escrito em fluxo para um ficheiro .partial temporário e renomeado no lugar quando completo, por isso um descarregamento interrompido retoma ficheiro a ficheiro e um descarregamento parcial nunca é confundido com um modelo instalado. A documentação, as imagens e os ficheiros GGUF do repositório são ignorados. Primeiro corre uma verificação de espaço em disco, que falha logo em vez de encher o disco:
Not enough disk space: 40 GB free, but about 270 GB is needed.
Os modelos são guardados por repositório em:
~/Library/Application Support/BromureAC/models/<org>--<name>/
Os modelos já em cache por outras ferramentas em ~/.cache/huggingface/hub são migrados uma vez para este diretório, através de hardlinks, para que nada seja descarregado duas vezes.
Qualquer repositório do Hugging Face já em formato MLX também pode ser obtido pelo nome org/repo a partir da linha de comandos (consulte Referência da linha de comandos); um modelo assim não é testado — sem garantia de chamadas de ferramentas nem de adequação à memória. Os repositórios GGUF são recusados, porque GGUF é o formato do Ollama e do llama.cpp, não do MLX:
That's a GGUF (Ollama/llama.cpp) model — Bromure serves MLX weights only.
Streaming, raciocínio e visão
Os turnos locais chegam token a token, tanto no motor no dispositivo como num servidor personalizado. O proxy transmite o texto à medida que é gerado, retendo só o suficiente do fim para retirar uma chamada de ferramenta que tenha escapado, e depois termina o turno com o resultado reparado.
Os modelos de raciocínio transmitem o seu raciocínio como blocos de raciocínio nativos em todos os formatos de transmissão, por isso os agentes mostram-no como mostram o raciocínio de um modelo de nuvem; o raciocínio não é reintroduzido na transcrição. Os modelos com visão (sondados num servidor personalizado, ou assinalados no catálogo) aceitam imagens: o proxy traduz os blocos de imagem entre formatos de transmissão.
Nota: O primeiro turno de uma sessão paga o preenchimento prévio, pelo modelo, de todo o prompt do agente — muitas vezes dezenas de milhares de tokens de prompt de sistema e esquemas de ferramentas — antes de aparecer o primeiro token. Num modelo 8B isto pode demorar um minuto ou mais; os turnos seguintes reutilizam a cache do motor e começam quase de imediato.
Reparação de chamadas de ferramentas
Os modelos quantizados emitem muitas vezes uma chamada de ferramenta como texto simples em vez de uma chamada estruturada. Um proxy de reparação à frente de cada motor local — no dispositivo ou servidor personalizado — guarda cada resposta em buffer e reconhece as muitas formas que uma chamada escapada pode ter, por exemplo:
<function name="write_file" arguments='{…}'>
<tool_call>{…}</tool_call>
[{"name": "…", "parameters": {…}}]
bem como o formato nativo do Qwen3-Coder <function=Name><parameter=k>v</parameter></function> e o formato de canais do Gemma. Transforma o que encontra em chamadas de ferramentas corretas no formato de transmissão próprio do agente. Também deteta um modelo que anuncia uma ação («Now I'll create the file:») e depois para sem chamar a ferramenta, e volta a pedir até duas vezes para recuperar a chamada. A reparação está sempre ativa na inferência local.
Os problemas do motor chegam ao agente como erros legíveis no seu próprio formato de transmissão, por exemplo:
Local inference engine unreachable (starting up, reloading a model, or stopped) — retry in a moment.
Desempenho esperado
- O débito depende do modelo e do chip. Um modelo pequeno como o Qwen3 8B é rápido em qualquer Mac suportado; as grandes versões de mistura de especialistas são mais lentas e precisam de muito mais memória. A janela Métricas de inferência mostra os débitos reais no seu hardware.
- O primeiro pedido paga o carregamento do modelo para a memória.
- Os turnos seguintes são mais baratos. O motor mantém uma cache de prompt por conversa, por isso cada turno do agente só processa os tokens novos.
- A geração é serializada. O motor executa uma geração de cada vez; várias sessões ocupadas partilham a GPU em vez de correrem em paralelo.
Monitorizar a inferência local
Duas janelas do menu Janela permitem-lhe acompanhar a inferência local sem o Console.app.
Métricas de inferência
Janela › Métricas de inferência… abre uma janela de telemetria em direto (Métricas de inferência) com um separador por motor em uso — o motor integrado e cada servidor personalizado para onde as suas máquinas apontam. O separador integrado, com o título Local inference e o endereço de loopback do motor, mostra cartões Decode tok/s, Prefill tok/s, Running, Waiting, In flight, Avg latency, Cache hit, Metal mem, Gen tokens e Prompt tokens, uma lista Modelos carregados e uma secção All metrics com a tabela em bruto.
A janela consulta de 5 em 5 segundos, só enquanto está aberta. Os débitos de descodificação e de preenchimento prévio são médias de todo o tempo de vida, por isso mantêm-se estáveis. Quando o motor está em baixo, a janela mostra engine not reachable; durante uma geração longa pode mostrar brevemente engine busy (timed out). Os servidores personalizados que não expõem um endpoint de métricas (o Ollama, por exemplo) também têm cartões, medidos pelo proxy a partir do tráfego que retransmite.
Registo do motor de inferência
Janela › Log do motor de inferência… abre um acompanhamento em direto (Log do motor de inferência) da saída do motor e dos seus eventos de ciclo de vida — carregamentos de modelos, «serving», estatísticas por pedido, e qualquer falta de memória, falha, reinício ou erro de carregamento. As linhas têm cores (vermelho para falhas, verde para eventos saudáveis, laranja para avisos, azul para trabalho em curso). A barra de ferramentas tem um campo Filtrar…, uma caixa Rolagem automática, Copiar e Limpar; sem nada registado ainda, diz No inference-engine activity yet. O buffer guarda as últimas 5000 linhas, e cada linha é também escrita no erro padrão da aplicação.
Dica: Se um modelo local parecer lento ou bloqueado, abra primeiro o Log do motor de inferência: carregamentos de modelos, expulsões, reinícios por falta de memória e erros de arquitetura não suportada aparecem todos lá em texto simples.
Referência da linha de comandos
Os comandos model gerem os modelos no dispositivo; falam com a aplicação em execução. Os comandos que atuam sobre uma máquina recebem um argumento final <vm>: um ID de VM ou um nome de espaço de trabalho. Consulte CLI, API e MCP para o conjunto de comandos à volta.
bromure-cli model catalog [--all] [--offline]
bromure-cli model pull <catalog-id | org/repo>
bromure-cli model ls
bromure-cli model use <catalog-id | org/repo> <vm>
bromure-cli model rm <catalog-id | org/repo>
bromure-cli vm routing cloud|local <vm>
| Comando | O que faz |
|---|---|
model catalog | Lista os modelos do catálogo com emblemas de adequação e de chamadas de ferramentas e um visto nos instalados, e mostra a memória unificada do seu Mac. Atualiza primeiro o catálogo publicado (sem erro fatal se falhar). --all inclui os modelos que não cabem; --offline usa só o catálogo incluído e o que está em cache. |
model pull | Descarrega um modelo por ID de catálogo ou qualquer repositório MLX do Hugging Face, depois de verificar que é MLX (e não GGUF) e que há espaço em disco, com uma barra de progresso. |
model ls | Lista os modelos instalados com o espaço em disco que ocupam. |
model use | Define o modelo local que os agentes de uma máquina em execução usam, sem reiniciar os agentes. Numa máquina que use um servidor personalizado, funciona qualquer ID aceite pelo servidor. |
model rm | Elimina os pesos de um modelo instalado. |
vm routing | Muda uma máquina em execução entre encaminhamento na nuvem e local. |
model use e vm routing são ajustes em direto para uma máquina em execução; é no quadro Modelos que se configuram os modelos de uma máquina, e é ele que se aplica no próximo arranque da máquina.
Comandos de diagnóstico internos
Estes subcomandos ocultos existem para desenvolvimento e resolução de problemas.
| Comando | Finalidade |
|---|---|
bromure-cli model _mlx-serve <repo> | Inicia o servidor MLX para um modelo e fica bloqueado, mostrando a sua porta e chave para testes com curl. |
bromure-cli model _mlx-selftest <repo> | Carrega um modelo, gera uma vez e mostra o tempo até ao primeiro token e a velocidade de descodificação. |
bromure-cli model _repair-serve --engine-port <port> | Executa o proxy de reparação de chamadas de ferramentas sozinho, contra um motor em execução. |
bromure-cli model _tc-test <path> | Executa a recuperação de chamadas de ferramentas num ficheiro de texto guardado. |
bromure-cli model _spec-bench <main-repo> --draft <draft-repo> | Faz benchmark da descodificação especulativa desligada versus ligada para um par de modelos. |