Modelos y proveedores
Cada agente de programación de Bromure Agentic Coding — Claude Code, Codex, Grok, Kimi y omp — obtiene su modelo y sus credenciales de un único sitio: el tablero Modelos. Registras cada fuente una vez (el inicio de sesión o la clave de API de un proveedor en la nube, Amazon Bedrock, OpenRouter, un servidor de inferencia propio o modelos que se ejecutan en este Mac), y todas las máquinas pueden usarla. Una máquina (un espacio de trabajo, en el editor de ajustes) hereda estos ajustes globales de forma predeterminada y puede sustituir cualquier parte de ellos.
Este capítulo cubre el propio tablero, el inicio y el cierre de sesión, la elección de modelos por agente, las sustituciones por máquina, cómo llegan los agentes a proveedores que no son los suyos, qué les pasa a los agentes en ejecución cuando cambias algo, y el motor integrado en el dispositivo: su catálogo, las descargas, las ventanas de supervisión y los comandos model. Para la lista campo por campo del panel del espacio de trabajo, consulta Ajustes de modelos. Fusion — varios modelos respondiendo a un mismo prompt — es una función aparte, con su propio panel.
Nota: Las versiones anteriores tenían un panel Agentes por espacio de trabajo, un panel Modelos locales y un modo de enrutamiento «híbrido» que pasaba de la nube a un modelo local. Los tres han desaparecido. Las elecciones de modelos y credenciales viven en el tablero Modelos, y el tráfico de una máquina va o a la nube o a un motor local, agente por agente, como se describe a continuación.
Dónde aparece el tablero Modelos
El mismo tablero de dos columnas aparece en cuatro sitios:
| Dónde | Qué edita | Cuándo se aplican los cambios |
|---|---|---|
| Preferencias › Modelos (⌘,) | Los ajustes globales que heredan todas las máquinas. | De inmediato: el tablero guarda a medida que editas, con independencia del botón Guardar de la ventana de Preferencias. |
| El editor de ajustes de una máquina › Modelos | La sustitución de los ajustes globales propia de esa máquina (consulta Sustituciones por máquina). | Cuando pulsas Guardar en el editor. |
| El paso Modelos del asistente de bienvenida | Los ajustes globales, solo en el primer arranque. | De inmediato. |
| Las Preferencias de un Mac remoto replicado (Ajustes para: un host remoto) | Los ajustes globales de ese Mac, obtenidos por el túnel con las claves de API ocultas. | Cuando pulsas Guardar. Consulta Acceso remoto. |
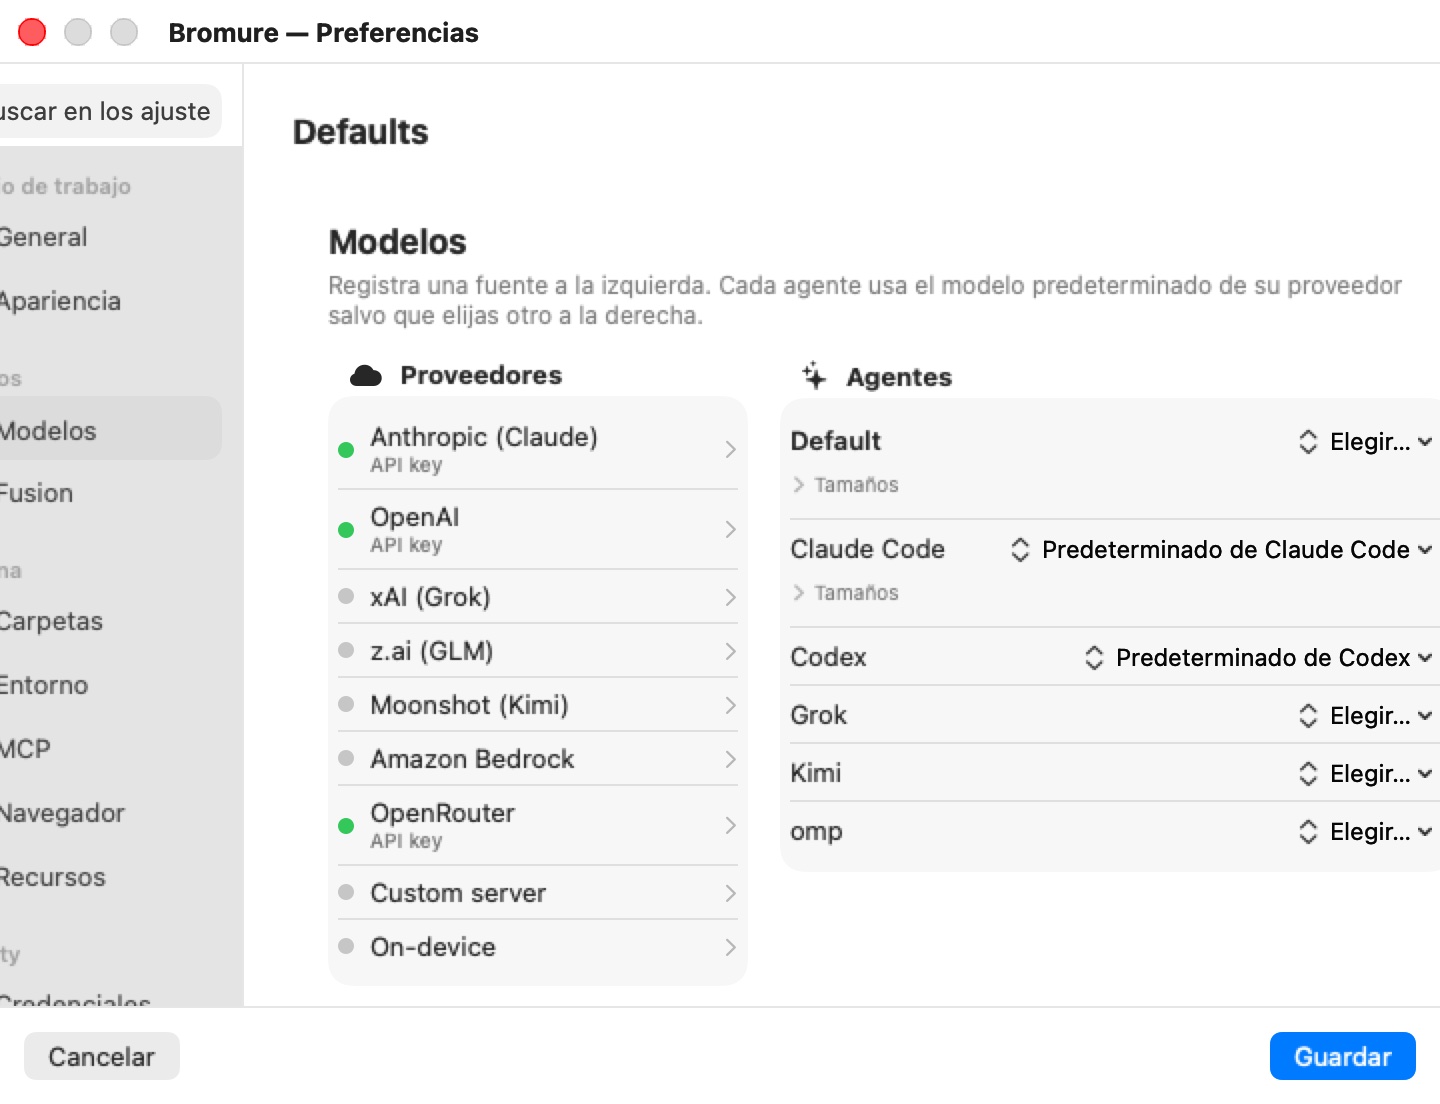
El panel se titula Modelos, con la leyenda «Registra una fuente a la izquierda. Cada agente usa el modelo predeterminado de su proveedor salvo que elijas otro a la derecha.» A la izquierda está la columna Proveedores; a la derecha, la columna Agentes.
Proveedores
Cada fila de Proveedores tiene un punto de estado y un subtítulo de una línea. Verde significa utilizable; gris, sin configurar; naranja, un inicio de sesión de suscripción caducado. Haz clic en una fila para abrir su ventana emergente de configuración.
| Proveedor | Cómo se configura | Notas |
|---|---|---|
| Anthropic (Claude) | Inicio de sesión por suscripción o clave de API | Proveedor nativo de Claude Code. |
| OpenAI | Inicio de sesión por suscripción o clave de API | Proveedor nativo de Codex. |
| xAI (Grok) | Inicio de sesión por suscripción o clave de API | Proveedor nativo de Grok. |
| z.ai (GLM) | Solo clave de API | El plan de programación de z.ai se entrega como clave de API; no hay nada en lo que iniciar sesión. |
| Moonshot (Kimi) | Inicio de sesión por suscripción o clave de API | Proveedor nativo de Kimi. |
| Amazon Bedrock | Usar Amazon Bedrock, región opcional y clave de API opcional | Consulta Amazon Bedrock. |
| OpenRouter | Solo clave de API | Su lista de modelos se obtiene en directo de OpenRouter. |
| Servidor personalizado | URL del servidor y clave de API opcional | Cualquier servidor compatible con OpenAI. Consulta Servidor personalizado. |
| En el dispositivo | Descargar modelos | Los modelos MLX se ejecutan en la GPU de este Mac. Consulta Modelos en el dispositivo. |
El subtítulo de la fila indica cómo está configurado un proveedor: API key, subscription, inicio de sesión caducado, Credenciales de AWS (Bedrock), un nombre de host (servidor personalizado) o N installed (en el dispositivo). En la sustitución de una máquina también puede decir inherited API key, inherited subscription, overridden here u off here.
Inicio de sesión y claves de API
Para Anthropic, OpenAI, xAI y Moonshot, la ventana emergente empieza con Sign in with proveedor («Inicio de sesión interactivo en una VM temporal: no se necesita clave de API.») y luego «o pega una clave de API» encima de un campo Clave de API. Sin ninguna de las dos, dice Aún no configurado.
Al iniciar sesión se ejecuta el inicio de sesión de la propia CLI del proveedor dentro de una VM desechable; la página del proveedor se abre en tu navegador, y el inicio de sesión capturado se guarda en el anfitrión, nunca en una máquina. Una vez iniciada la sesión, la ventana emergente muestra Sesión iniciada con cuánto hace, además de Volver a iniciar sesión… y Cerrar sesión…. Cerrar sesión… pide confirmación — «¿Cerrar sesión en proveedor?», «Los espacios de trabajo que usan este inicio de sesión dejarán de funcionar hasta que vuelvas a iniciar sesión.» — con Cerrar sesión / Cancelar.
Si el proveedor rechaza un inicio de sesión guardado (por ejemplo, porque se revocó en otro sitio), la ventana emergente pasa a un panel naranja Inicio de sesión caducado que explica que las sesiones no pueden usarlo hasta que vuelvas a iniciar sesión, con un botón Volver a iniciar sesión bien visible.
Una clave de API pegada tiene prioridad sobre una suscripción del mismo proveedor: escribir una clave pasa ese proveedor a pago por uso. Las claves se guardan cifradas (consulta Dónde se guardan los ajustes).
Nota: Una suscripción solo puede alimentar a su propio agente: una suscripción de Claude mueve Claude Code, una de ChatGPT mueve Codex, y así sucesivamente. Por eso, un proveedor con sesión iniciada por suscripción nunca aparece en el menú de modelos de otro agente y no puede usarse en la fila Default. Las claves de API no tienen esa restricción.
Ámbito de la suscripción: todas las máquinas o solo una
Un inicio de sesión hecho desde Preferencias › Modelos siempre lo comparten todas las máquinas. Un inicio de sesión hecho desde el editor de ajustes de una máquina (su panel Modelos) termina con una pregunta: ¿Compartir con todos los espacios de trabajo? — «¿Usar este inicio de sesión de proveedor para todos los espacios de trabajo de Bromure (sustituyendo el inicio de sesión de proveedor propio de cada uno), o solo para este?» — con Todos los espacios de trabajo y Solo este espacio de trabajo.
- Todos los espacios de trabajo guarda el inicio de sesión como el compartido y elimina cualquier inicio de sesión propio de una máquina para ese proveedor, para que el nuevo sea de verdad el que usan todas las máquinas.
- Solo este espacio de trabajo lo guarda solo para esa máquina. Una máquina con inicio de sesión propio siempre lo usa antes que el compartido.
Cuando el inicio de sesión se hizo desde un Mac remoto replicado y nadie responde la pregunta, la opción predeterminada es Solo este espacio de trabajo.
Amazon Bedrock
La ventana emergente de Bedrock explica: «Cualquier agente puede ejecutarse en Amazon Bedrock: Claude Code de forma nativa, los demás a través de la API compatible con OpenAI de Bedrock. Firma las solicitudes con las credenciales de AWS propias de cada espacio de trabajo (Credenciales → AWS), o pega una clave de API de Bedrock.»
- Activa Usar Amazon Bedrock.
- Opcionalmente, define la Región de AWS. Si se deja vacía, cada máquina usa la región de sus propias credenciales de AWS o, si no,
us-east-1. - Opcionalmente, pega una Clave de API de Bedrock (opcional; si no, firman las credenciales de AWS). Sin clave, el anfitrión firma cada solicitud con las credenciales de AWS de la máquina, de su panel Credenciales; las credenciales nunca entran en la VM.
Activar Bedrock rellena el modelo principal de Claude Code con un ID de modelo Claude de Bedrock. Los ID de modelo son los que usa Bedrock (por ejemplo us.anthropic.claude-sonnet-4-6); elígelos por agente en el menú o escribe el tuyo con ID personalizado…. Bedrock no tiene un endpoint que enumere los modelos, así que el menú ofrece una lista corta seleccionada.
Un agente en Bedrock sin clave de API solo está listo para arrancar en máquinas que tengan credenciales de AWS. Desactivar Usar Amazon Bedrock borra todas las elecciones de modelo que apuntaban a Bedrock, y esos agentes vuelven a sus valores predeterminados.
Servidor personalizado
Un Servidor personalizado es cualquier servidor de inferencia compatible con OpenAI — vLLM, Ollama, LM Studio, llama-server — en este Mac o en otro punto de tu red. La ventana emergente lo describe como «Recommended for local models.»
- Activa Activado.
- Introduce la URL del servidor (por ejemplo
http://127.0.0.1:11434/v1) y, si el servidor la necesita, una Clave de API (opcional). - Pulsa Probar conexión. Si va bien, muestra N model(s) y los modelos del servidor aparecen en el menú de cada agente, en Servidor personalizado; si falla, muestra el error del servidor.
Con un servidor personalizado, el ID del modelo es el del propio servidor, tal cual (por ejemplo qwen3:32b). El proxy de reparación del anfitrión traduce el formato de red de cada agente (mensajes de Anthropic, chat de OpenAI, responses de OpenAI) al /v1/chat/completions del servidor y de vuelta, y la ventana de contexto del modelo y su soporte de visión y razonamiento se sondean en el servidor y se pasan a los agentes. No se inicia ningún proceso de motor en el Mac para un servidor personalizado.
Modelos en el dispositivo
En el dispositivo abre una lista de modelos del catálogo — «MLX models run in-process on this Mac (N GB) — the lazy backup, nothing to install.» Cada fila muestra el nombre del modelo, una insignia de encaje (Fits, Tight o Won't fit) y su tamaño de descarga, y una acción:
| Control | Significado |
|---|---|
| Obtener | Descarga el modelo. Desactivado cuando no cabe en este Mac. |
| Barra de progreso + ✕ | Descargando; ✕ cancela y elimina la descarga parcial. |
| Reanudar | Una descarga interrumpida (la app se cerró o falló); continúa donde se detuvo. |
| Reintentar | La descarga falló; pasa el puntero por encima para ver el motivo. |
| Quitar | Instalado; quita los pesos y borra cualquier elección de modelo que los usara. |
Los modelos instalados aparecen en el menú de cada agente en En el dispositivo. Las descargas las comparten todas las máquinas. El catálogo, las reglas de encaje y el motor se describen en El motor en el dispositivo.
Agentes: elegir modelos
La columna Agentes tiene una fila Default y luego una fila por agente: Claude Code, Codex, Grok, Kimi y omp. Cada fila tiene una pastilla de modelo; haz clic en ella para elegir.
Qué muestra una pastilla:
- Agente default — no hay nada elegido y el proveedor propio del agente está configurado, así que el agente usa el modelo predeterminado de ese proveedor, exactamente como haría su propio «Default» de
/model. No tienes que elegir nada. - Elegir… — no hay nada elegido y nada se resuelve para este agente.
- Un ID de modelo, con un punto de color según su origen (azul: un proveedor en la nube; menta: el servidor personalizado; morado: en el dispositivo; naranja, tachado y marcado · no disponible: un proveedor al que este agente no puede llegar — consulta Qué agente llega a qué proveedor). · heredado tras el ID significa que el valor viene de la fila Default (o, en una sustitución de máquina, de los ajustes globales). Una ✕ junto a una elección explícita la borra.
El menú de la pastilla enumera cada proveedor utilizable al que el agente puede llegar como un submenú de ID de modelo (una lista seleccionada combinada con la lista de modelos en directo del proveedor, cuando la hay), y luego Servidor personalizado y En el dispositivo cuando están configurados. Cada submenú de proveedor termina con ID personalizado…, que pide «The id exactly as the backend names it (e.g. claude-opus-5, glm-4.6, qwen3-coder).» Para un agente con una elección explícita, el menú ofrece además Usar predeterminado (o Use agent’s default cuando no hay nada fijado en la fila Default) para borrarla.
Si el menú no tiene nada que ofrecer, lo dice: Configura primero un proveedor; No configured provider can power agent cuando todos los proveedores configurados quedan fuera del alcance de ese agente; o Una suscripción solo puede alimentar a su propio agente cuando los únicos proveedores configurados son suscripciones de otros agentes. En Servidor personalizado, Prueba la conexión para listar los modelos significa que aún no se ha sondeado el servidor.
La fila Default
Un modelo en la fila Default se aplica a todos los agentes que no tienen elección propia, incluidos los agentes cuyo propio proveedor está configurado y que, de otro modo, usarían el modelo predeterminado de su proveedor. Deja Default en Elegir… si quieres que cada agente use el modelo predeterminado de su propio proveedor.
Tamaños
Claude Code usa tres posiciones de modelo; todos los demás agentes usan un solo modelo. Las filas Default y Claude Code tienen una sección Tamaños con dos pastillas más:
| Tamaño | Posición de Claude Code |
|---|---|
| Large | ≈ opus |
| (pastilla principal) | ≈ sonnet |
| Small | ≈ haiku (tareas de fondo y rápidas) |
Sin definir, las posiciones grande y pequeña siguen los valores predeterminados de Claude Code. Tamaños se abre sola cuando una de ellas está definida. En la fila Claude Code, Restaurar valores predeterminados descarta todas las elecciones propias de Claude Code para que vuelva a heredar la fila Default. Codex, Grok, Kimi y omp solo usan la pastilla principal.
Qué agente llega a qué proveedor
Cada agente llega a su propio proveedor de forma nativa. También se le puede dirigir a algunos otros proveedores, que el anfitrión le conecta:
| Agente | Proveedor nativo | También llega a |
|---|---|---|
| Claude Code | Anthropic (suscripción o clave) | Amazon Bedrock (el modo Bedrock propio de Claude Code); OpenRouter y z.ai (directamente, a través de sus endpoints compatibles con Anthropic, clave de API); servidor personalizado; en el dispositivo |
| Codex | OpenAI | Amazon Bedrock, OpenRouter, xAI, Moonshot (a través del proxy de reparación del anfitrión, clave de API); servidor personalizado; en el dispositivo |
| Grok | xAI | Amazon Bedrock, OpenRouter, Moonshot (proxy de reparación); servidor personalizado; en el dispositivo |
| Kimi | Moonshot | Amazon Bedrock, OpenRouter, xAI (proxy de reparación); servidor personalizado; en el dispositivo |
| omp | Anthropic, solo clave de API | Amazon Bedrock, OpenRouter, xAI, Moonshot (proxy de reparación); z.ai cuando el propio omp se cambia a él; servidor personalizado; en el dispositivo |
En la ruta del proxy de reparación, el agente dentro de la VM habla con el anfitrión, que traduce el formato de red del agente, guarda la clave real (o firma para Bedrock) y reenvía la solicitud. La clave nunca entra en la VM. Las rutas de OpenRouter y z.ai de Claude Code, en cambio, apuntan el agente directamente al endpoint compatible con Anthropic del proveedor (https://openrouter.ai/api, https://api.z.ai/api/anthropic), con una clave sustituta que el anfitrión cambia por la real en la red, como hace con cualquier credencial de la nube (consulta Credenciales y el límite de red).
El menú de modelos de un agente solo ofrece los proveedores a los que puede llegar. Claude Code solo habla el dialecto de Anthropic, así que su menú no tiene modelos de OpenAI, xAI ni Moonshot; la API compatible con OpenAI de z.ai no es una a la que se puedan conectar los demás agentes, así que el menú de Claude Code es el único menú de agente que ofrece modelos de z.ai (omp cambiado a z.ai llega por su cuenta).
Una elección guardada antes de dejar de ser alcanzable — o heredada de la fila Default por un agente que no puede usarla — aparece en naranja, tachada, seguida de · no disponible. Su descripción emergente explica: «Agent can’t use provider models, so it runs on its own provider instead. Pick another model.»
omp no tiene proveedor propio en el tablero y no puede usar suscripciones; dale un proveedor con clave de API.
Sustituciones por máquina
El editor de ajustes de una máquina tiene un panel Modelos (en el grupo Modelos). De forma predeterminada muestra un interruptor, Ajustes de modelos personalizados para este espacio de trabajo, desactivado — «Inheriting the global settings (Preferences → Models).» — y un resumen Modelos heredados: los modelos globales Large / Medium / Small y los proveedores configurados.
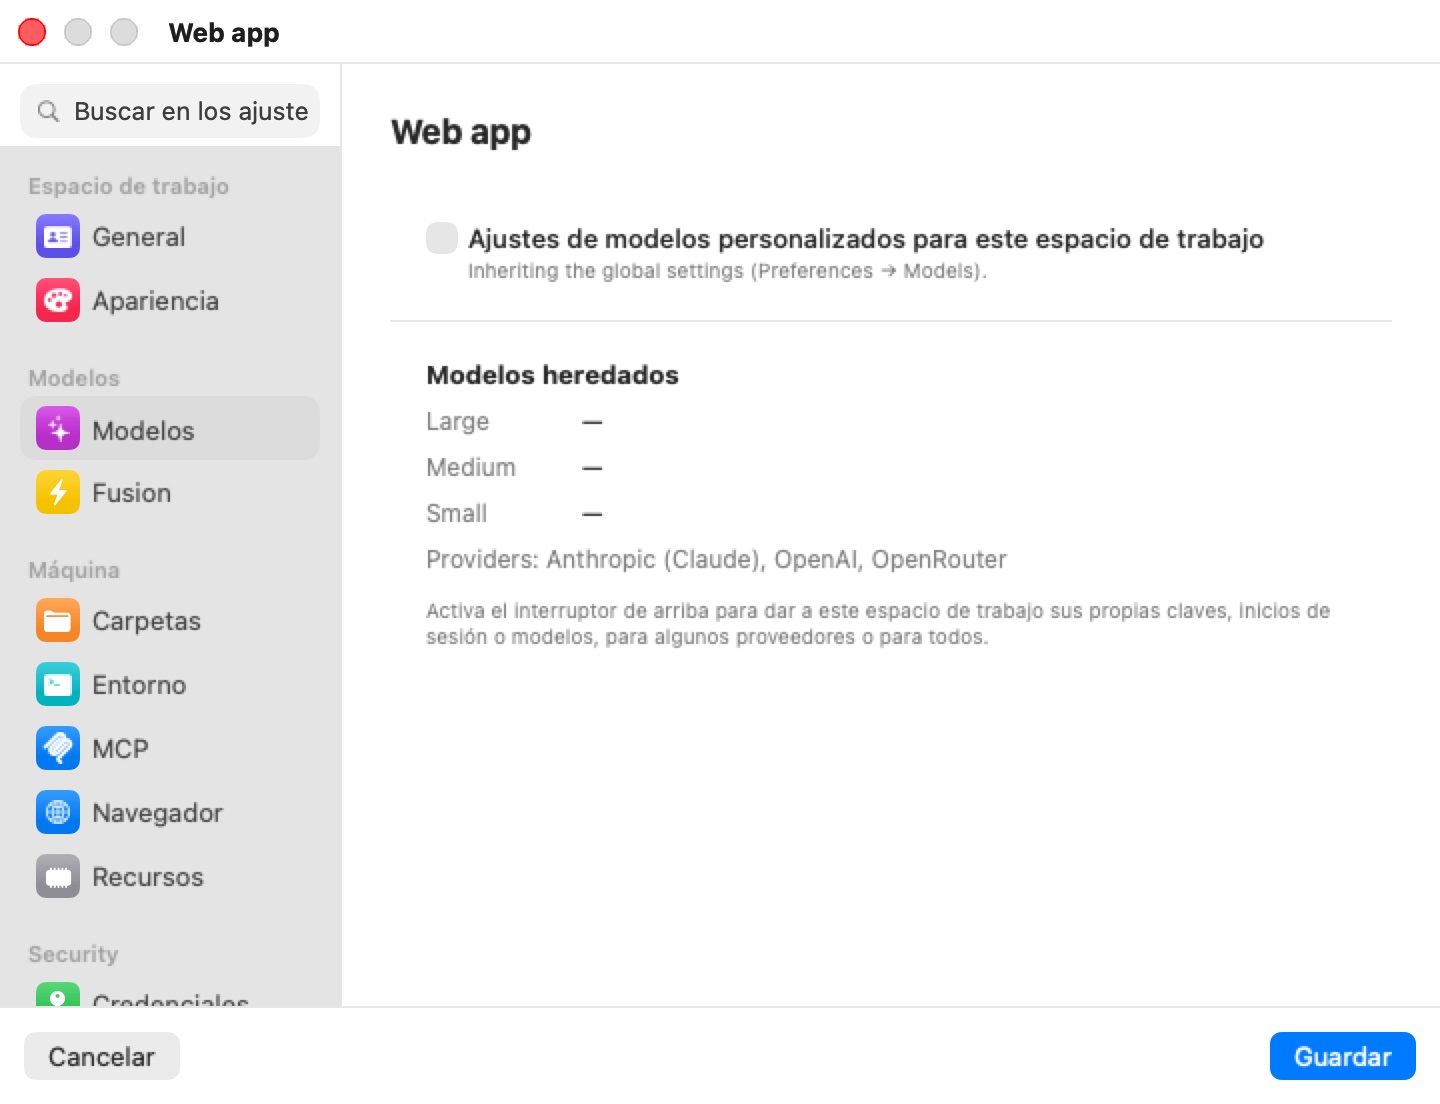
Activa el interruptor y elige uno de dos modos:
- Heredar, con cambios (el predeterminado) — «Starts from the global settings; only what you set below is different here.» Aparece el tablero completo, con los ajustes globales y los cambios de esta máquina por encima. Todo lo que no toques sigue los ajustes globales en directo: un proveedor que registres después globalmente también aparece aquí.
- Independiente — «This workspace has its own providers, logins and model choices below — the global settings are ignored.» Pasar a Independiente parte de una copia de lo que está en vigor, así que nada cambia hasta que edites.
En el modo Heredar, con cambios, cada ventana emergente de proveedor indica de dónde viene el proveedor y te deja cambiarlo solo para esta máquina:
| Etiqueta | Significado |
|---|---|
| Inherited from Preferences → Models (API key / subscription / AWS credentials). | Se usa la credencial global. No usar en este espacio de trabajo la excluye, «— or override it below» con la clave o el inicio de sesión propio de esta máquina. |
| Not used in this workspace — the global settings have it. | La has excluido. Usar el proveedor global vuelve a incluirla. |
| This workspace's own credential. | Esta máquina tiene su propia clave o inicio de sesión. Usar el proveedor global la descarta. |
| This workspace's own server. / Usar el servidor global | Lo mismo para el servidor personalizado. |
Las pastillas de modelo funcionan como en el tablero global; una pastilla sin cambios muestra · heredado, y borrar una elección explícita la devuelve al valor global (Usar el ajuste global).
La sustitución se guarda con la máquina cuando pulsas Guardar. Las claves escritas en una sustitución se guardan cifradas con los demás secretos de la máquina.
Cambiar de modelo en máquinas en ejecución
Nunca necesitas reiniciar una máquina por un cambio de modelo o de credenciales. Cuando registras un proveedor, pegas o cambias una clave, inicias o cierras sesión, pasas un agente a otro modelo o guardas la sustitución de una máquina:
- El anfitrión actualiza lo que leen los agentes de la máquina — la tabla de sustitución de credenciales, el entorno y los archivos de configuración de los agentes — en todas las máquinas en ejecución.
- Cada agente cuyas credenciales o modelo han cambiado de verdad se detiene en su pestaña y se relanza de inmediato con sus opciones de reanudación, así que la conversación continúa. En la vista de chat, la sesión conserva su transcripción; en un terminal, ves al agente salir y volver al momento.
- Los agentes cuya configuración no ha cambiado se dejan en paz, y la VM en sí nunca se reinicia.
- La configuración de Fusion de la máquina sigue los mismos ajustes: sus ramas y su juez se reevalúan, y el interruptor ⚡ se desactiva si quedan menos de dos modelos utilizables.
Los cambios en el tablero global se aplican aproximadamente un segundo y medio después de que dejes de escribir.
Advertencia: Reiniciar un agente interrumpe lo que estuviera haciendo en ese momento. Si un agente está en mitad de un turno largo, espera a que termine antes de cambiar su modelo o sus credenciales.
Dónde se guardan los ajustes
Los ajustes globales se guardan en ~/Library/Application Support/BromureAC/models.enc, cifrados con la misma clave que el almacén de secretos de los espacios de trabajo. La sustitución de una máquina se guarda con la máquina, y sus claves en el almacén de secretos cifrado. Los inicios de sesión de las suscripciones los guarda en el anfitrión el proxy de credenciales, compartidos o por máquina según lo elegido más arriba. Ninguno de estos secretos se copia nunca a una VM: los agentes reciben valores sustitutos que el anfitrión cambia en la red.
Límites
- Solo hay suscripciones para Anthropic, OpenAI, xAI y Moonshot, y cada una alimenta únicamente a su propio agente.
- omp solo usa claves de API.
- Un servidor personalizado tiene que ser compatible con OpenAI.
- Dentro de una máquina, todos los agentes que se ejecutan en local (servidor personalizado o en el dispositivo) comparten un único modelo local: prevalece la elección del agente principal.
- El motor en el dispositivo usa la única GPU del Mac y ejecuta una generación a la vez.
- El tablero Modelos no está disponible en Bromure Remote para iPhone, iPad o Apple Vision Pro; edita los modelos desde un Mac.
El motor en el dispositivo
El motor en el dispositivo ejecuta modelos de programación de pesos abiertos en la GPU de tu Mac con el framework MLX de Apple: sin ida y vuelta a la nube, sin factura por token y sin que el código salga del Mac. No hay nada que instalar, ni entorno de Python ni servidor que configurar.
Nota: La inferencia se ejecuta en el Mac, no dentro de la VM. El dispositivo gráfico Metal opcional del navegador no ofrece a Linux cómputo GPU ni acceso a MLX, así que el invitado llega al motor cruzando el límite de red. Se necesita Apple Silicon, el mismo requisito que la propia app.
El proceso del motor
El motor MLX se ejecuta como proceso hijo supervisado del propio binario de la app (bromure-ac model _mlx-engine), no dentro de la app. Cargar un modelo demasiado grande para la memoria del Mac solo mata el proceso hijo del motor, nunca la app ni sus VM en ejecución. La app reinicia automáticamente un motor que se ha caído, hasta tres veces; después se rinde con la línea de registro engine child crashed repeatedly — giving up (a model likely OOMs this Mac). El proceso hijo se termina cuando se cierra la app, y un huérfano que quede tras un fallo grave se recoge en el siguiente arranque.
Un único motor sirve a todas las máquinas. Se vincula a un puerto de loopback asignado por el kernel en 127.0.0.1 — nunca 0.0.0.0 y nunca el 11434 habitual de Ollama, para que una instalación aparte de Ollama o LM Studio siga funcionando. Puede mantener varios modelos dentro de un presupuesto de memoria (la memoria unificada del Mac menos cierto margen), cargando cada uno en su primer uso y expulsando el menos usado recientemente cuando la memoria escasea.
Mientras el motor se prepara, la barra de herramientas de una máquina muestra una pequeña insignia de CPU con un indicador de actividad («Starting local engine…»); se vuelve verde cuando el modelo está listo, o naranja si el motor no pudo arrancar (pasa el puntero por encima para ver el motivo).
Cómo llega el invitado
Los agentes de la VM nunca hablan directamente con el motor. Apuntan al host sintético https://bromure.llm, que no tiene DNS real: el proxy del lado del anfitrión lo intercepta, aplica el mismo análisis de inyección de prompts y la misma captura de trazas que al tráfico de la nube, y reenvía la solicitud al motor. La inferencia local nunca es un punto ciego.
Los agentes se configuran con el ID de modelo real que sirve el motor (por ejemplo mlx-community/Qwen3-8B-4bit-DWQ), para que su dimensionado del contexto y sus consultas de capacidades vean la realidad.
Nota: Un modelo cuya arquitectura aún no admite el motor MLX falla con un error claro y permanente — «its architecture … isn't supported by the on-device engine yet — pick a different model» — devuelto como error de cliente para que el agente no lo reintente en bucle. Usa un servidor personalizado para esos modelos.
El catálogo
El catálogo es una lista seleccionada de modelos MLX preconvertidos, cada uno comprobado en lo que más importa en la programación agéntica — llamadas a herramientas fiables — y cada uno con un tamaño de descarga y una cantidad mínima de memoria unificada.
Un catálogo base viene dentro de la app para que la lista funcione sin conexión desde el primer día. La app obtiene un catálogo actualizado de https://dl.bromure.io/mlx/catalog.json; un catálogo publicado más reciente sustituye al base en lugar de combinarse con él. Un modelo retirado del catálogo publicado desaparece de la lista, salvo que ya lo tengas instalado.
El catálogo incluido tiene cuatro modelos Qwen3, todos verificados en llamadas a herramientas:
| Modelo | Descarga | Memoria unificada mínima | Recomendado |
|---|---|---|---|
| Qwen3 8B (4-bit DWQ MLX) | 4.3 GB | 16 GB | Sí |
| Qwen3-Coder 30B-A3B (4-bit DWQ MLX) | 17 GB | 32 GB | Sí |
| Qwen3-Coder-Next 80B-A3B (mxfp4 MLX) | 42 GB | 96 GB | Sí |
| Qwen3-Coder 480B-A35B (4-bit MLX) | 270 GB | 512 GB | No |
Un catálogo actualizado puede añadir versiones más recientes o más grandes sin actualizar la app.
La insignia de encaje
Cada modelo se evalúa frente a la memoria unificada de tu Mac:
- Won't fit — el mínimo del modelo supera tu memoria. La fila aparece atenuada y no se puede descargar.
- Tight — se carga, con menos de 16 GB de sobra para todo lo demás.
- Fits — caben el mínimo más 16 GB de margen.
Por ejemplo, Qwen3 8B (mínimo de 16 GB) muestra Tight en un Mac de 16 GB y Fits a partir de 32 GB.
Descargas y almacenamiento
Los pesos llegan directamente de huggingface.co a través de un descargador integrado, sin Python y sin conversión. Cada archivo de pesos se escribe en continuo en un archivo .partial temporal y se renombra al completarse, de modo que una descarga interrumpida se reanuda archivo por archivo y una descarga parcial nunca se toma por un modelo instalado. La documentación, las imágenes y los archivos GGUF del repositorio se omiten. Primero se comprueba el espacio en disco, que falla pronto en lugar de llenar el disco:
Not enough disk space: 40 GB free, but about 270 GB is needed.
Los modelos se guardan por repositorio en:
~/Library/Application Support/BromureAC/models/<org>--<name>/
Los modelos ya almacenados en caché por otras herramientas en ~/.cache/huggingface/hub se migran una vez a este directorio mediante enlaces duros, para que nada se descargue dos veces.
Cualquier repositorio de Hugging Face que ya esté en formato MLX también puede obtenerse por su nombre org/repo desde la línea de comandos (consulta Referencia de la línea de comandos); un modelo así no está probado: no hay garantía de llamadas a herramientas ni de encaje en memoria. Los repositorios GGUF se rechazan, porque GGUF es el formato de Ollama y llama.cpp, no de MLX:
That's a GGUF (Ollama/llama.cpp) model — Bromure serves MLX weights only.
Streaming, razonamiento y visión
Los turnos locales llegan token a token, tanto con el motor en el dispositivo como con un servidor personalizado. El proxy retransmite el texto a medida que se genera, reteniendo solo lo justo del final para quitar una llamada a herramienta filtrada, y luego termina el turno con el resultado reparado.
Los modelos de razonamiento transmiten su razonamiento como bloques de razonamiento nativos en todos los formatos de red, así que los agentes lo muestran como el de un modelo en la nube; el razonamiento no se vuelve a meter en la transcripción. Los modelos con visión (sondeados en un servidor personalizado o marcados en el catálogo) aceptan imágenes: el proxy traduce los bloques de imagen entre formatos de red.
Nota: El primer turno de una sesión paga el prellenado, por parte del modelo, de todo el prompt del agente — a menudo decenas de miles de tokens de prompt de sistema y esquemas de herramientas — antes de que aparezca el primer token. En un modelo 8B puede tardar un minuto o más; los turnos siguientes reutilizan la caché del motor y empiezan casi de inmediato.
Reparación de llamadas a herramientas
Los modelos cuantizados suelen emitir una llamada a herramienta como texto plano en lugar de una llamada estructurada. Un proxy de reparación delante de cada motor local — en el dispositivo o servidor personalizado — almacena en búfer cada respuesta y reconoce las muchas formas que puede tomar una llamada filtrada, por ejemplo:
<function name="write_file" arguments='{…}'>
<tool_call>{…}</tool_call>
[{"name": "…", "parameters": {…}}]
además del formato nativo de Qwen3-Coder <function=Name><parameter=k>v</parameter></function> y el formato de canales de Gemma. Convierte lo que encuentra en llamadas a herramientas correctas en el formato de red propio del agente. También detecta un modelo que anuncia una acción («Now I'll create the file:») y luego se detiene sin llamar a la herramienta, y vuelve a pedirlo hasta dos veces para recuperar la llamada. La reparación está siempre activa en la inferencia local.
Los problemas del motor llegan al agente como errores legibles en su propio formato de red, por ejemplo:
Local inference engine unreachable (starting up, reloading a model, or stopped) — retry in a moment.
Rendimiento esperado
- El rendimiento depende del modelo y del chip. Un modelo pequeño como Qwen3 8B va ágil en cualquier Mac compatible; las versiones grandes de mezcla de expertos son más lentas y necesitan mucha más memoria. La ventana Métricas de inferencia muestra las velocidades reales en tu hardware.
- La primera solicitud paga la carga del modelo en memoria.
- Los turnos siguientes salen más baratos. El motor mantiene una caché de prompts por conversación, así que cada turno del agente solo procesa los tokens nuevos.
- La generación está serializada. El motor ejecuta una generación a la vez; varias sesiones ocupadas comparten la GPU en lugar de ejecutarse en paralelo.
Supervisar la inferencia local
Dos ventanas del menú Ventana te permiten seguir la inferencia local sin Console.app.
Métricas de inferencia
Ventana › Métricas de inferencia… abre una ventana de telemetría en directo (Métricas de inferencia) con una pestaña por motor en uso: el motor integrado más cada servidor personalizado al que apuntan tus máquinas. La pestaña integrada, titulada Local inference con la dirección de loopback del motor, muestra tarjetas de Decode tok/s, Prefill tok/s, Running, Waiting, In flight, Avg latency, Cache hit, Metal mem, Gen tokens y Prompt tokens, una lista Modelos cargados y una sección desplegable All metrics con la tabla en bruto.
La ventana consulta cada 5 segundos, solo mientras está abierta. Las velocidades de decodificación y prellenado son promedios de toda la vida útil, así que se leen estables. Cuando el motor está caído, la ventana muestra engine not reachable; durante una generación larga puede mostrar brevemente engine busy (timed out). Los servidores personalizados que no exponen un endpoint de métricas (Ollama, por ejemplo) también tienen tarjetas, que el proxy mide a partir del tráfico que retransmite.
Registro del motor de inferencia
Ventana › Registro del motor de inferencia… abre un seguimiento en directo (Registro del motor de inferencia) de la salida del motor y de sus eventos de ciclo de vida: cargas de modelos, «serving», estadísticas por solicitud, y cualquier falta de memoria, fallo, reinicio o error de carga. Las líneas van por colores (rojo para fallos, verde para eventos correctos, naranja para advertencias, azul para trabajo en curso). La barra de herramientas tiene un campo Filtrar…, una casilla Desplazamiento automático, Copiar y Borrar; si aún no hay nada registrado, dice No inference-engine activity yet. El búfer conserva las últimas 5000 líneas, y cada línea se escribe también en la salida de error estándar de la app.
Consejo: Si un modelo local va lento o se atasca, abre primero el Registro del motor de inferencia: las cargas de modelos, las expulsiones, los reinicios por falta de memoria y los errores de arquitectura no compatible aparecen todos ahí en texto plano.
Referencia de línea de comandos
Los comandos model gestionan los modelos en el dispositivo; hablan con la app en ejecución. Los comandos que actúan sobre una máquina reciben un argumento final <vm>: un ID de VM o un nombre de espacio de trabajo. Consulta CLI, API y MCP para el conjunto de comandos del que forman parte.
bromure-cli model catalog [--all] [--offline]
bromure-cli model pull <catalog-id | org/repo>
bromure-cli model ls
bromure-cli model use <catalog-id | org/repo> <vm>
bromure-cli model rm <catalog-id | org/repo>
bromure-cli vm routing cloud|local <vm>
| Comando | Qué hace |
|---|---|
model catalog | Enumera los modelos del catálogo con insignias de encaje y de llamadas a herramientas y una marca en los instalados, e imprime la memoria unificada de tu Mac. Primero actualiza el catálogo publicado (sin error fatal si falla). --all incluye los modelos que no caben; --offline usa solo el catálogo incluido y el de la caché. |
model pull | Descarga un modelo por ID de catálogo o cualquier repositorio MLX de Hugging Face, tras comprobar que es MLX (no GGUF) y que hay espacio en disco, con una barra de progreso. |
model ls | Enumera los modelos instalados con su uso de disco. |
model use | Fija el modelo local que usan los agentes de una máquina en ejecución, sin reiniciar los agentes. En una máquina que usa un servidor personalizado, funciona cualquier ID que acepte el servidor. |
model rm | Elimina los pesos de un modelo instalado. |
vm routing | Cambia una máquina en ejecución entre enrutamiento en la nube y local. |
model use y vm routing son ajustes en directo para una máquina en ejecución; en el tablero Modelos es donde se configuran los modelos de una máquina, y es lo que se aplica la próxima vez que arranque.
Comandos de diagnóstico internos
Estos subcomandos ocultos existen para desarrollo y solución de problemas.
| Comando | Propósito |
|---|---|
bromure-cli model _mlx-serve <repo> | Inicia el servidor MLX para un modelo y se queda bloqueado, mostrando su puerto y su clave para pruebas con curl. |
bromure-cli model _mlx-selftest <repo> | Carga un modelo, genera una vez e imprime el tiempo hasta el primer token y la velocidad de decodificación. |
bromure-cli model _repair-serve --engine-port <port> | Ejecuta el proxy de reparación de llamadas a herramientas por sí solo, frente a un motor en ejecución. |
bromure-cli model _tc-test <path> | Ejecuta el rescate de llamadas a herramientas sobre un archivo de texto guardado. |
bromure-cli model _spec-bench <main-repo> --draft <draft-repo> | Compara el rendimiento de la decodificación especulativa desactivada frente a activada para un par de modelos. |