モデルとプロバイダー
Bromure Agentic Coding のすべてのコーディングエージェント――Claude Code、Codex、Grok、Kimi、omp――は、モデルと認証情報を 1 か所から取得します。モデル ボードです。各ソース(クラウドプロバイダーのサインインや API キー、Amazon Bedrock、OpenRouter、独自の推論サーバー、この Mac 上で動くモデル)を一度登録すれば、どのマシンからも使えます。マシン(設定エディタではワークスペース)は既定でこのグローバル設定を引き継ぎ、その任意の部分を上書きできます。
この章では、ボードそのもの、サインインとログアウト、エージェントごとのモデル選択、マシンごとの上書き、エージェントが自分のもの以外のプロバイダーにどう到達するか、何かを変更したときに実行中のエージェントがどうなるか、そして組み込みのオンデバイスエンジン(カタログ、ダウンロード、監視ウインドウ、model コマンド)を扱います。ワークスペースのペインのフィールドごとの一覧は、モデル設定を参照してください。Fusion――複数のモデルが 1 つのプロンプトに答える機能――は、専用のペインを持つ別の機能です。
メモ: 以前のリリースには、ワークスペースごとの エージェント ペイン、ローカルモデル ペイン、クラウドからローカルモデルへフォールバックする「ハイブリッド」ルーティングモードがありました。この 3 つはなくなりました。モデルと認証情報の選択はモデルボードにあり、マシンのトラフィックは、以下で説明するとおり、エージェントごとにクラウドかローカルのバックエンドのどちらかへ向かいます。
モデルボードが表示される場所
同じ 2 列のボードが 4 か所に表示されます。
| 場所 | 編集対象 | 変更が反映されるタイミング |
|---|---|---|
| 環境設定 › モデル(⌘,) | すべてのマシンが引き継ぐグローバル設定。 | 即座に――ボードは編集と同時に保存され、環境設定ウインドウの 保存 ボタンとは独立しています。 |
| マシンの設定エディタ › モデル | そのマシン独自のグローバル設定の上書き(マシンごとの上書きを参照)。 | エディタで 保存 をクリックしたとき。 |
| オンボーディングウィザードの モデル ステップ | グローバル設定(初回起動時のみ)。 | 即座に。 |
| ミラーしているリモート Mac の環境設定(設定対象: リモートホスト) | その Mac のグローバル設定。トンネル経由で取得され、API キーは伏せられます。 | 保存 をクリックしたとき。リモートアクセスを参照してください。 |
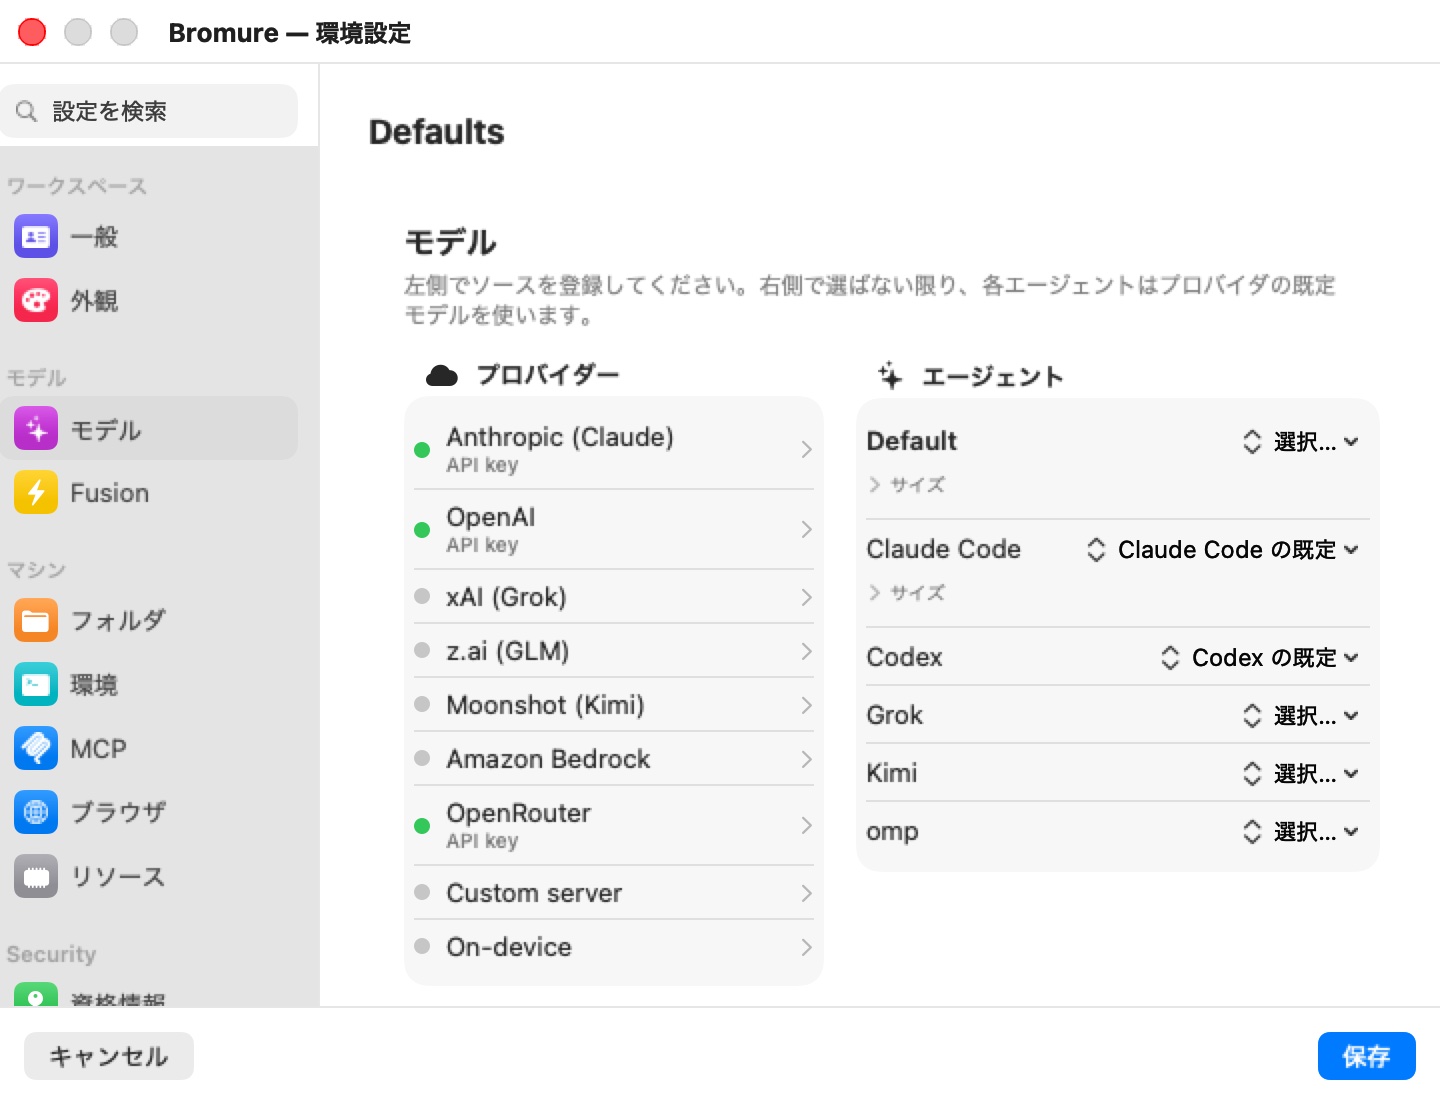
ペインの見出しは モデル で、説明は「左側でソースを登録してください。右側で選ばない限り、各エージェントはプロバイダの既定モデルを使います。」です。左側が プロバイダー の列、右側が エージェント の列です。
プロバイダー
プロバイダー の各行には、状態を示すドットと 1 行のサブタイトルがあります。緑は使用可能、グレーは未設定、オレンジはサブスクリプションのサインインが期限切れであることを示します。行をクリックすると、その設定用ポップオーバーが開きます。
| プロバイダー | 設定方法 | 備考 |
|---|---|---|
| Anthropic (Claude) | サブスクリプションのサインインまたは API キー | Claude Code のネイティブプロバイダー。 |
| OpenAI | サブスクリプションのサインインまたは API キー | Codex のネイティブプロバイダー。 |
| xAI (Grok) | サブスクリプションのサインインまたは API キー | Grok のネイティブプロバイダー。 |
| z.ai (GLM) | API キーのみ | z.ai のコーディングプランは API キーとして提供されるため、サインインするものはありません。 |
| Moonshot (Kimi) | サブスクリプションのサインインまたは API キー | Kimi のネイティブプロバイダー。 |
| Amazon Bedrock | Amazon Bedrock を使用、任意のリージョン、任意の API キー | Amazon Bedrockを参照してください。 |
| OpenRouter | API キーのみ | モデル一覧は OpenRouter からリアルタイムで取得されます。 |
| カスタムサーバー | サーバー URL と任意の API キー | 任意の OpenAI 互換サーバー。カスタムサーバーを参照してください。 |
| オンデバイス | モデルをダウンロード | MLX モデルがこの Mac の GPU で動きます。オンデバイスモデルを参照してください。 |
行のサブタイトルは、プロバイダーがどう設定されているかを示します。API key、subscription、サインインの期限切れ、AWS 認証情報(Bedrock)、ホスト名(カスタムサーバー)、N installed(オンデバイス)です。マシンの上書きでは、inherited API key、inherited subscription、overridden here、off here と表示されることもあります。
サインインと API キー
Anthropic、OpenAI、xAI、Moonshot では、ポップオーバーの先頭に Sign in with プロバイダー(「一時的な VM での対話型ログイン — API キーは不要です。」)があり、その後に API キー フィールドの上の「または API キーを貼り付け」が続きます。どちらもない場合は まだ設定されていません。 と表示されます。
サインインでは、使い捨ての VM の中でプロバイダー自身の CLI ログインが実行されます。プロバイダーのページがブラウザで開き、取り込まれたサインインはマシンではなくホストに保存されます。サインインすると、ポップオーバーには経過時間付きの サインイン済み と、再度サインイン… と ログアウト… が表示されます。ログアウト… は確認を求めます――「プロバイダー からログアウトしますか?」「このサインインを使用しているワークスペースは、再度サインインするまで動作しなくなります。」――ログアウト/キャンセル。
プロバイダーが保存済みのサインインを拒否した場合(たとえば別の場所で取り消された場合)、ポップオーバーはオレンジの サインインの期限切れ パネルに切り替わり、再度サインインするまでセッションがそれを使えないことを説明し、目立つ 再度サインイン ボタンを表示します。
同じプロバイダーでは、貼り付けた API キーがサブスクリプションより優先されます。キーを入力すると、そのプロバイダーは従量課金に切り替わります。キーは暗号化して保存されます(設定の保存場所を参照)。
メモ: サブスクリプションが動かせるのは自分のエージェントだけです――Claude のサブスクリプションは Claude Code を、ChatGPT のサブスクリプションは Codex を動かす、という具合です。そのため、サブスクリプションでサインインしたプロバイダーがほかのエージェントのモデルメニューに表示されることはなく、Default 行でも使えません。API キーにはそのような制限はありません。
サブスクリプションの範囲:すべてのマシンか 1 台だけか
環境設定 › モデル から始めたサインインは、常にすべてのマシンで共有されます。マシンの設定エディタ(その モデル ペイン)から始めたサインインは、最後に質問が表示されます:すべてのワークスペースで共有しますか? ――「この プロバイダー のサインインを Bromure のすべてのワークスペースで使いますか(各ワークスペース独自の プロバイダー のサインインを置き換えます)、それともこのワークスペースだけで使いますか?」――すべてのワークスペース と このワークスペースのみ。
- すべてのワークスペース は、サインインを共有のものとして保存し、そのプロバイダーについてマシン独自のサインインをすべて削除するので、新しいサインインが本当にすべてのマシンで使われるようになります。
- このワークスペースのみ は、そのマシンのためだけに保存します。独自のサインインを持つマシンは、常に共有のものよりそちらを優先して使います。
ミラーしているリモート Mac からサインインを始め、誰もその質問に答えなかった場合、選択は既定で このワークスペースのみ になります。
Amazon Bedrock
Bedrock のポップオーバーには次のように説明されています:「どのエージェントも Amazon Bedrock で動かせます。Claude Code はネイティブに、ほかのエージェントは Bedrock の OpenAI 互換 API を通じて動きます。各ワークスペース独自の AWS 認証情報(資格情報 → AWS)でリクエストに署名するか、Bedrock API キーを貼り付けてください。」
- Amazon Bedrock を使用 をオンにします。
- 必要に応じて AWS リージョン を設定します。空欄の場合、各マシンは自身の AWS 認証情報のリージョンを使い、それもなければ
us-east-1を使います。 - 必要に応じて Bedrock API キー(省略可 — 省略時は AWS 資格情報で署名) を貼り付けます。キーがない場合、ホストはマシンの 資格情報 ペインにある AWS 認証情報で各リクエストに署名します。認証情報が VM に入ることはありません。
Bedrock を有効にすると、Claude Code のメインモデルに Bedrock の Claude のモデル ID があらかじめ入ります。モデル ID は Bedrock が使うものです(たとえば us.anthropic.claude-sonnet-4-6)。エージェントごとにメニューから選ぶか、カスタム ID… で自分で入力します。Bedrock にはモデル一覧を返すエンドポイントがないため、メニューには厳選した短い一覧が表示されます。
API キーのない Bedrock 上のエージェントは、AWS 認証情報を持つマシンでしか起動できません。Amazon Bedrock を使用 をオフにすると、Bedrock を指していたモデル選択がすべて消去され、それらのエージェントは既定値に戻ります。
カスタムサーバー
カスタムサーバー は、この Mac 上またはネットワーク上の別の場所にある、任意の OpenAI 互換推論サーバー――vLLM、Ollama、LM Studio、llama-server――です。ポップオーバーでは「Recommended for local models.」と紹介されています。
- 有効 をオンにします。
- サーバー URL(たとえば
http://127.0.0.1:11434/v1)と、サーバーが必要とする場合は API キー(省略可) を入力します。 - 接続をテスト をクリックします。成功すると N model(s) と表示され、サーバーのモデルが各エージェントのメニューの カスタムサーバー の下に現れます。失敗するとサーバーのエラーが表示されます。
カスタムサーバーでは、モデル ID はサーバー自身の ID そのままです(たとえば qwen3:32b)。ホストの修復プロキシが、各エージェントの通信形式(Anthropic messages、OpenAI chat、OpenAI responses)とサーバーの /v1/chat/completions との間を相互に変換し、モデルのコンテキストウィンドウ、ビジョン、推論への対応はサーバーに問い合わせてエージェントに渡されます。カスタムサーバーの場合、Mac 上でエンジンのプロセスは起動しません。
オンデバイスモデル
オンデバイス を開くと、カタログのモデル一覧が表示されます――「MLX models run in-process on this Mac (N GB) — the lazy backup, nothing to install.」各行には、モデル名、適合バッジ(Fits、Tight、Won't fit)、ダウンロードサイズ、そして 1 つの操作が表示されます。
| 操作 | 意味 |
|---|---|
| 入手 | モデルをダウンロードします。この Mac に収まらない場合は無効です。 |
| 進捗バー + ✕ | ダウンロード中です。✕ でキャンセルし、途中までのダウンロードを削除します。 |
| 再開 | 中断したダウンロード(アプリの終了やクラッシュ)を、止まったところから再開します。 |
| 再試行 | ダウンロードに失敗しました。ポインタを合わせると理由が表示されます。 |
| 削除 | インストール済みです。重みを削除し、それを使っていたモデル選択を消去します。 |
インストールしたモデルは、各エージェントのメニューの オンデバイス の下に表示されます。ダウンロードはすべてのマシンで共有されます。カタログ、適合の基準、エンジンについてはオンデバイスエンジンで説明します。
エージェント:モデルの選択
エージェント の列には Default 行があり、続いてエージェントごとの行――Claude Code、Codex、Grok、Kimi、omp――があります。各行にはモデルのチップがあり、クリックして選択します。
チップに表示されるもの:
- エージェント default ――何も選ばれておらず、エージェント自身のプロバイダーが設定されているため、そのエージェントはそのプロバイダーの既定モデルで動きます。エージェント自身の
/modelの「Default」とまったく同じです。何も選ぶ必要はありません。 - 選択… ――何も選ばれておらず、このエージェントについて解決できるものもありません。
- モデル ID と、その提供元を示す色付きのドット(青:クラウドプロバイダー、ミント:カスタムサーバー、紫:オンデバイス、オレンジで取り消し線付きかつ · 利用不可 の印:このエージェントが到達できないプロバイダー――どのエージェントがどのプロバイダーに到達できるかを参照)。ID の後の · 継承 は、値が Default 行(マシンの上書きではグローバル設定)から来ていることを意味します。明示的な選択の横の ✕ で、その選択を消去できます。
チップのメニューには、エージェントが到達できる使用可能なプロバイダーが、それぞれモデル ID のサブメニュー(厳選した一覧に、あればプロバイダーのリアルタイムのモデル一覧を合わせたもの)として並び、設定されていれば カスタムサーバー と オンデバイス が続きます。各プロバイダーのサブメニューの最後には カスタム ID… があり、「The id exactly as the backend names it (e.g. claude-opus-5, glm-4.6, qwen3-coder).」を尋ねます。明示的に選択しているエージェントでは、メニューに デフォルトを使用(Default 行に何も設定されていない場合は Use agent’s default)もあり、選択を消去できます。
メニューに表示できるものがない場合は、その旨が表示されます。先にプロバイダーを設定してください、設定済みのプロバイダーがすべてそのエージェントから到達できない場合は No configured provider can power agent、設定済みのプロバイダーがほかのエージェント用のサブスクリプションだけの場合は サブスクリプションはそれ自身のエージェントにしか使えません です。カスタムサーバー の下の 接続をテストしてモデルを一覧表示 は、サーバーにまだ問い合わせていないことを意味します。
Default 行
Default 行のモデルは、独自の選択を持たないすべてのエージェントに適用されます。自身のプロバイダーが設定されていて、本来ならそのプロバイダーの既定モデルを使うエージェントも含まれます。各エージェントに自身のプロバイダーの既定モデルを使わせたい場合は、Default を 選択… のままにしておきます。
サイズ
Claude Code は 3 つのモデル枠を使い、ほかのエージェントはモデルを 1 つだけ使います。Default と Claude Code の行には、追加のチップ 2 つを含む サイズ の折りたたみがあります。
| サイズ | Claude Code の枠 |
|---|---|
| Large | ≈ opus |
| (メインのチップ) | ≈ sonnet |
| Small | ≈ haiku(バックグラウンドや素早いタスク) |
未設定の場合、大きい枠と小さい枠は Claude Code 自身の既定値に従います。どちらかが設定されていると、サイズ は自動的に開きます。Claude Code 行の デフォルトに戻す は、Claude Code 独自の選択をすべて破棄し、再び Default 行を引き継がせます。Codex、Grok、Kimi、omp はメインのチップだけを使います。
どのエージェントがどのプロバイダーに到達できるか
各エージェントは、自身のプロバイダーにネイティブに到達します。さらに、ホストが橋渡しすることで、いくつかのほかのプロバイダーにも向けられます。
| エージェント | ネイティブプロバイダー | ほかに到達できるもの |
|---|---|---|
| Claude Code | Anthropic(サブスクリプションまたはキー) | Amazon Bedrock(Claude Code 独自の Bedrock モード)、OpenRouter と z.ai(それぞれの Anthropic 互換エンドポイント経由で直接、API キー)、カスタムサーバー、オンデバイス |
| Codex | OpenAI | Amazon Bedrock、OpenRouter、xAI、Moonshot(ホストの修復プロキシ経由、API キー)、カスタムサーバー、オンデバイス |
| Grok | xAI | Amazon Bedrock、OpenRouter、Moonshot(修復プロキシ)、カスタムサーバー、オンデバイス |
| Kimi | Moonshot | Amazon Bedrock、OpenRouter、xAI(修復プロキシ)、カスタムサーバー、オンデバイス |
| omp | Anthropic(API キーのみ) | Amazon Bedrock、OpenRouter、xAI、Moonshot(修復プロキシ)、omp 自体を切り替えた場合の z.ai、カスタムサーバー、オンデバイス |
修復プロキシの経路では、VM 内のエージェントはホストと通信し、ホストがエージェントの通信形式を変換し、本物のキーを保持して(Bedrock の場合は署名して)リクエストを転送します。キーが VM に入ることはありません。一方、Claude Code の OpenRouter と z.ai の経路では、エージェントをプロバイダーの Anthropic 互換エンドポイント(https://openrouter.ai/api、https://api.z.ai/api/anthropic)に直接向け、代用キーを使います。ホストは、ほかのクラウド認証情報と同様に、通信経路上でそれを本物のキーに差し替えます(認証情報とワイヤ境界を参照)。
エージェントのモデルメニューには、そのエージェントが到達できるプロバイダーだけが表示されます。Claude Code は Anthropic の方言しか話さないため、そのメニューには OpenAI、xAI、Moonshot のモデルはありません。z.ai の OpenAI 互換 API は、ほかのエージェントを橋渡しできる API ではないため、z.ai のモデルを表示するエージェントのメニューは Claude Code のものだけです(z.ai に切り替えた omp は自力で到達します)。
到達できなくなる前に保存された選択――または、それを使えないエージェントが Default 行から引き継いだ選択――は、オレンジで取り消し線付きになり、後ろに · 利用不可 が付きます。ツールチップには「Agent can’t use provider models, so it runs on its own provider instead. Pick another model.」と説明されます。
omp にはボード上に自分のプロバイダーがなく、サブスクリプションも使えません。API キーを使うプロバイダーを割り当ててください。
マシンごとの上書き
マシンの設定エディタには モデル ペイン(モデル グループの中)があります。既定では、オフになった このワークスペース用のカスタムモデル設定 スイッチ――「Inheriting the global settings (Preferences → Models).」――と、継承されたモデル の要約(グローバルの Large / Medium / Small のモデルと、設定済みのプロバイダー)が表示されます。
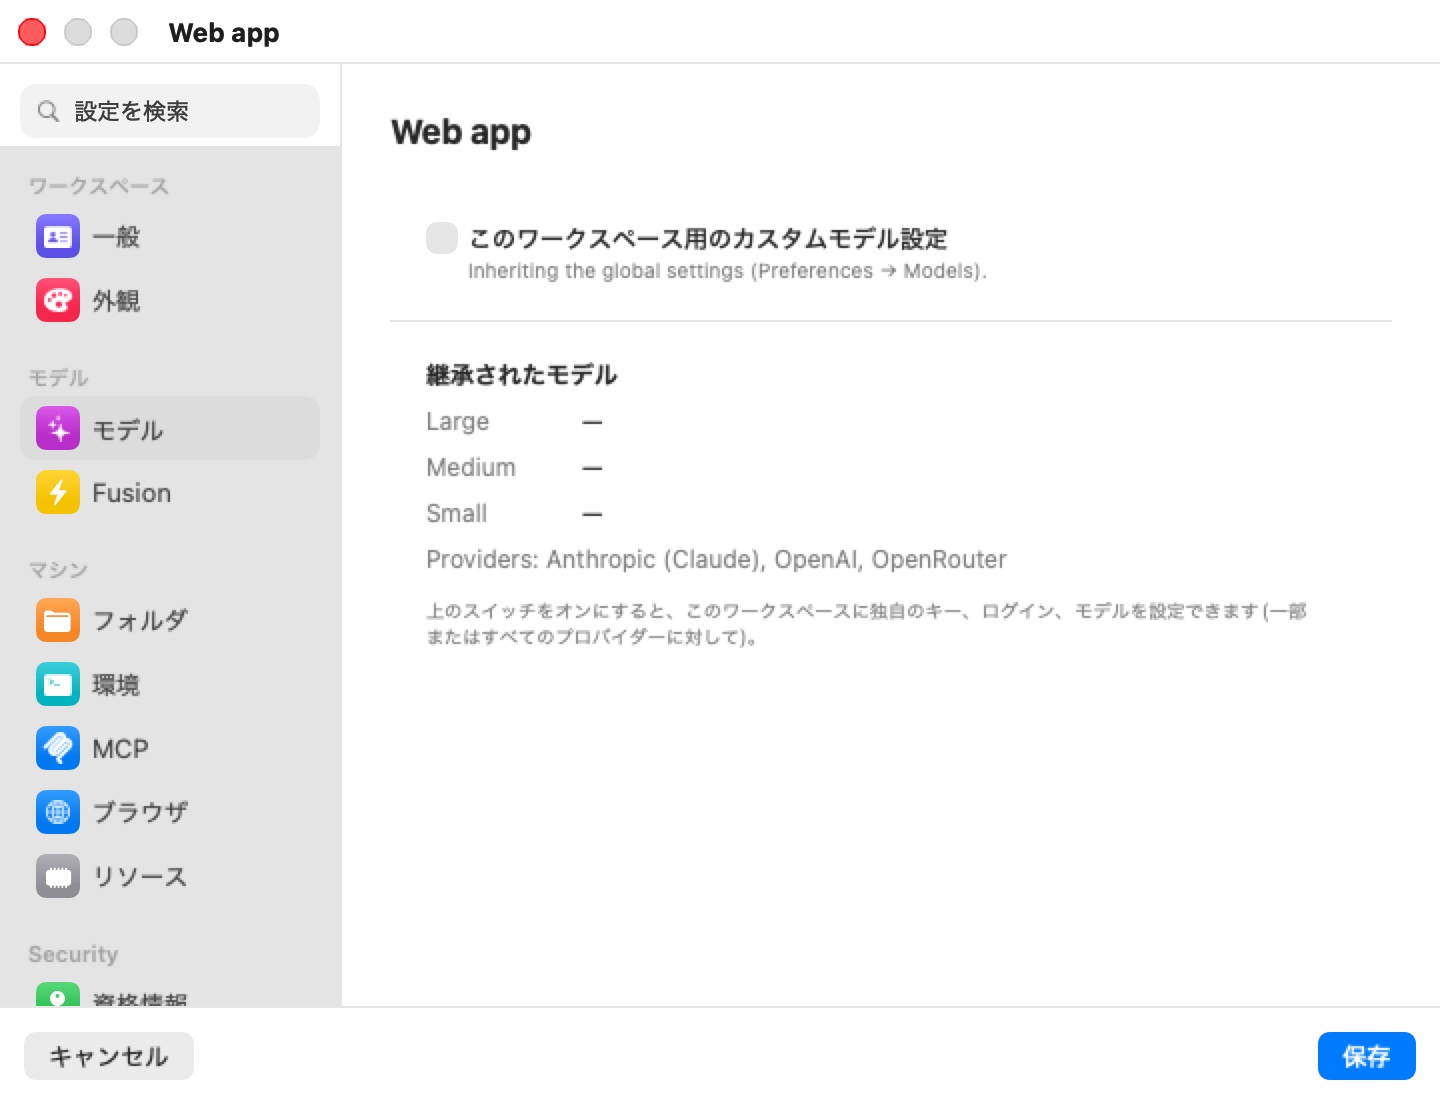
スイッチをオンにし、2 つのモードのどちらかを選びます。
- 継承して変更(既定)――「Starts from the global settings; only what you set below is different here.」ボードがすべて表示され、グローバル設定の上にこのマシンの変更が重なって表示されます。触れていない部分はすべて、引き続きグローバル設定にリアルタイムで従います――後からグローバルに登録したプロバイダーも、ここに表示されます。
- スタンドアロン ――「This workspace has its own providers, logins and model choices below — the global settings are ignored.」スタンドアロンに切り替えると、現在有効な設定のコピーから始まるので、編集するまで何も変わりません。
継承して変更 モードでは、各プロバイダーのポップオーバーに、そのプロバイダーがどこから来ているかが表示され、このマシンについてだけそれを変更できます。
| ラベル | 意味 |
|---|---|
| Inherited from Preferences → Models (API key / subscription / AWS credentials). | グローバルの認証情報が使われます。このワークスペースでは使用しない で除外するか、「— or override it below」でこのマシン独自のキーやサインインで上書きします。 |
| Not used in this workspace — the global settings have it. | 除外しています。グローバルのプロバイダーを使用 で再び含めます。 |
| This workspace's own credential. | このマシンに独自のキーやサインインがあります。グローバルのプロバイダーを使用 でそれを破棄します。 |
| This workspace's own server. / グローバルのサーバーを使用 | カスタムサーバーについて同様です。 |
モデルのチップはグローバルのボードと同じように動作します。変更していないチップには · 継承 と表示され、明示的な選択を消去するとグローバルの値(グローバル設定を使用)に戻ります。
上書きは、保存 をクリックしたときにマシンとともに保存されます。上書きに入力したキーは、マシンのほかの秘密情報とともに暗号化して保存されます。
実行中のマシンでのモデルの変更
モデルや認証情報を変更するためにマシンを再起動する必要はありません。プロバイダーを登録したとき、キーを貼り付けたり変更したりしたとき、サインインやログアウトをしたとき、エージェントを別のモデルに切り替えたとき、マシンの上書きを保存したときには:
- ホストは、実行中のすべてのマシンについて、マシンのエージェントが読むもの――認証情報の差し替えマップ、エージェントの環境と設定ファイル――を更新します。
- 認証情報やモデルが実際に変わったエージェントは、それぞれのタブで停止され、再開用のフラグを付けてすぐに再起動されるので、会話は続きます。チャット表示ではセッションのトランスクリプトがそのまま残り、ターミナルではエージェントが終了してすぐに戻ってくる様子が見えます。
- 設定が変わっていないエージェントはそのままで、VM 自体が再起動することはありません。
- マシンの Fusion の設定も同じ設定に従います。その各レッグと審査役が再評価され、使えるモデルが 2 つ未満になると ⚡ トグルは解除されます。
グローバルのボードでの変更は、入力をやめてから約 1.5 秒後に反映されます。
警告: エージェントを再起動すると、そのとき行っていた作業は中断されます。エージェントが長いターンの途中にある場合は、終わるのを待ってからモデルや認証情報を切り替えてください。
設定の保存場所
グローバル設定は ~/Library/Application Support/BromureAC/models.enc に、ワークスペースの秘密情報の保管庫と同じ鍵で暗号化されて保存されます。マシンの上書きはマシンとともに保存され、そのキーは暗号化された秘密情報ストアに入ります。サブスクリプションのサインインは、上で選んだとおり共有またはマシンごとに、認証情報プロキシがホスト側で保持します。これらの秘密情報が VM にコピーされることは一切ありません。エージェントには、ホストが通信経路上で差し替える代用値が渡されます。
制限事項
- サブスクリプションは Anthropic、OpenAI、xAI、Moonshot でのみ利用でき、それぞれ自分のエージェントしか動かせません。
- omp は API キーのみを使います。
- カスタムサーバーは OpenAI 互換である必要があります。
- 1 台のマシン内では、ローカルで動くすべてのエージェント(カスタムサーバーまたはオンデバイス)が 1 つのローカルモデルを共有します。メインエージェントの選択が優先されます。
- オンデバイスエンジンは Mac の 1 基の GPU を使い、一度に 1 つの生成しか実行しません。
- モデルボードは、iPhone、iPad、Apple Vision Pro 用の Bromure Remote では利用できません。モデルは Mac から編集してください。
オンデバイスエンジン
オンデバイスエンジンは、Apple の MLX フレームワークを使って、オープンウェイトのコーディングモデルを Mac の GPU で動かします――クラウドとの往復も、トークンごとの課金もなく、コードが Mac を出ることもありません。インストールするものも、Python 環境も、設定するサーバーもありません。
メモ: 推論は VM の中ではなく Mac 上で実行されます。ブラウザのオプションの Metal グラフィックスデバイスは Linux に GPU 演算や MLX へのアクセスを提供しないため、ゲストはワイヤ境界を越えてエンジンに到達します。Apple Silicon が必要です――アプリ自体と同じ要件です。
エンジンのプロセス
MLX エンジンは、アプリの中ではなく、アプリ自身のバイナリ(bromure-ac model _mlx-engine)の 監視下の子プロセス として動きます。Mac のメモリに対して大きすぎるモデルを読み込んでも、終了するのはエンジンの子プロセスだけで、アプリや実行中の VM が終了することはありません。アプリはクラッシュしたエンジンを最大 3 回まで自動で再起動し、それを超えるとログ行 engine child crashed repeatedly — giving up (a model likely OOMs this Mac) を出して断念します。子プロセスはアプリの終了時に終了され、強制終了で残った孤児プロセスは次回起動時に回収されます。
1 つのエンジンがすべてのマシンに対応します。エンジンは 127.0.0.1 上のカーネルが割り当てたループバックポートにバインドします――0.0.0.0 にも、Ollama の慣例である 11434 にもバインドしないので、別途インストールした Ollama や LM Studio もそのまま動きます。メモリの予算(Mac のユニファイドメモリから余裕分を引いたもの)の範囲で複数のモデルを保持でき、各モデルは最初の使用時に読み込まれ、メモリが足りなくなると最も長く使われていないものが追い出されます。
エンジンの準備中は、マシンのツールバーにスピナー付きの小さな CPU バッジ(「Starting local engine…」)が表示されます。モデルの準備ができると緑に、エンジンの起動に失敗するとオレンジになります(ポインタを合わせると理由が表示されます)。
ゲストからの到達方法
VM 内のエージェントがエンジンと直接通信することはありません。エージェントは実際の DNS を持たない合成ホスト https://bromure.llm を宛先にします。ホスト側のプロキシがそれを傍受し、クラウドのトラフィックと同じプロンプトインジェクションのスキャンとトレースの取得を適用して、リクエストをエンジンに転送します。ローカル推論が死角になることはありません。
エージェントには、エンジンが提供する実際のモデル ID(たとえば mlx-community/Qwen3-8B-4bit-DWQ)が設定されるので、コンテキストサイズの算出や機能の照会には実態がそのまま反映されます。
メモ: MLX エンジンがまだ対応していないアーキテクチャのモデルは、明確で恒久的なエラー――「its architecture … isn't supported by the on-device engine yet — pick a different model」――で失敗します。このエラーはクライアントエラーとして返されるので、エージェントが繰り返し再試行することはありません。そうしたモデルにはカスタムサーバーを使ってください。
カタログ
カタログは、変換済みの MLX モデルを厳選した一覧です。各モデルは、エージェント型コーディングで最も重要なこと――確実なツール呼び出し――について検証されており、ダウンロードサイズと必要なユニファイドメモリの最小量が記録されています。
アプリには基本のカタログが同梱されているので、初日からオフラインでも一覧が使えます。アプリは https://dl.bromure.io/mlx/catalog.json から更新されたカタログを取得します。公開された新しいカタログは、基本のカタログとマージされるのではなく、それを置き換えます。公開カタログから外れたモデルは、すでにインストールしていない限り一覧から消えます。
同梱のカタログには、ツール呼び出しが検証済みの Qwen3 モデルが 4 つ含まれています。
| モデル | ダウンロード | 最小ユニファイドメモリ | 推奨 |
|---|---|---|---|
| Qwen3 8B (4-bit DWQ MLX) | 4.3 GB | 16 GB | はい |
| Qwen3-Coder 30B-A3B (4-bit DWQ MLX) | 17 GB | 32 GB | はい |
| Qwen3-Coder-Next 80B-A3B (mxfp4 MLX) | 42 GB | 96 GB | はい |
| Qwen3-Coder 480B-A35B (4-bit MLX) | 270 GB | 512 GB | いいえ |
更新されたカタログでは、アプリを更新しなくても、より新しいビルドやより大きなビルドが追加されることがあります。
適合バッジ
各モデルは、あなたの Mac のユニファイドメモリと照らし合わせて判定されます。
- Won't fit ――モデルの最小量がメモリを超えています。行は薄く表示され、ダウンロードできません。
- Tight ――読み込めますが、ほかのすべてに使える余裕が 16 GB 未満です。
- Fits ――最小量に 16 GB の余裕を加えても収まります。
たとえば、Qwen3 8B(最小 16 GB)は、16 GB の Mac では Tight、32 GB 以上では Fits になります。
ダウンロードと保存
重みは組み込みのダウンローダーで huggingface.co から直接取得されます――Python も変換も不要です。各重みファイルは一時的な .partial ファイルに書き込まれ、完了すると名前を変えて配置されるので、中断したダウンロードはファイル単位で再開され、途中までのダウンロードがインストール済みのモデルと誤認されることはありません。リポジトリ内のドキュメント、画像、GGUF ファイルはスキップされます。最初にディスク容量のチェックが行われ、ディスクを埋め尽くす前にすぐ失敗します。
Not enough disk space: 40 GB free, but about 270 GB is needed.
モデルはリポジトリごとに次の場所に保存されます。
~/Library/Application Support/BromureAC/models/<org>--<name>/
ほかのツールが ~/.cache/huggingface/hub にすでにキャッシュしているモデルは、ハードリンクで一度だけこのディレクトリに移行されるので、二重にダウンロードされることはありません。
すでに MLX 形式になっている任意の Hugging Face リポジトリも、コマンドラインから org/repo の名前で取得できます(コマンドラインリファレンスを参照)。そうしたモデルは未検証で、ツール呼び出しやメモリへの適合は保証されません。GGUF のリポジトリは拒否されます。GGUF は MLX ではなく、Ollama と llama.cpp の形式だからです。
That's a GGUF (Ollama/llama.cpp) model — Bromure serves MLX weights only.
ストリーミング、思考、ビジョン
ローカルのターンは、オンデバイスエンジンでもカスタムサーバーでも、トークン単位でストリーミングされます。プロキシは生成されたテキストを順次中継しつつ、漏れ出たツール呼び出しを取り除けるだけの末尾部分を保留し、修復した結果でターンを締めくくります。
推論モデルは、どの通信形式でも思考をネイティブの思考ブロックとしてストリーミングするので、エージェントはクラウドモデルの思考と同じように表示します。思考はトランスクリプトに戻されません。ビジョン対応のモデル(カスタムサーバーに問い合わせたもの、またはカタログで印が付いたもの)は画像を受け付け、プロキシが通信形式間で画像ブロックを変換します。
メモ: セッションの最初のターンでは、最初のトークンが出る前に、エージェントのプロンプト全体――多くの場合、システムプロンプトとツールスキーマで数万トークン――をモデルがプリフィルする分の時間がかかります。8B のモデルでは 1 分以上かかることもありますが、以降のターンはエンジンのキャッシュを再利用するので、ほぼすぐに始まります。
ツール呼び出しの修復
量子化されたモデルは、ツール呼び出しを構造化された呼び出しではなくプレーンテキストとして出力することがよくあります。すべてのローカルバックエンド――オンデバイスまたはカスタムサーバー――の前に置かれた 修復プロキシ は、各応答をバッファリングし、漏れ出た呼び出しが取り得るさまざまな形を認識します。たとえば:
<function name="write_file" arguments='{…}'>
<tool_call>{…}</tool_call>
[{"name": "…", "parameters": {…}}]
のほか、Qwen3-Coder ネイティブの <function=Name><parameter=k>v</parameter></function> 形式や Gemma のチャネル形式も認識します。見つけたものは、エージェント自身の通信形式で正しいツール呼び出しに変換されます。また、アクションを予告して(「Now I'll create the file:」)ツールを呼ばずに止まってしまうモデルも検出し、最大 2 回まで再度促して呼び出しを回収します。ローカル推論では修復は常に有効です。
エンジンの問題は、エージェント自身の通信形式で読みやすいエラーとしてエージェントに返されます。たとえば:
Local inference engine unreachable (starting up, reloading a model, or stopped) — retry in a moment.
性能の目安
- スループットはモデルとチップによって決まります。 Qwen3 8B のような小さなモデルは、サポートされているどの Mac でも軽快に動きます。大規模な Mixture-of-Experts のビルドは遅く、はるかに多くのメモリを必要とします。推論メトリクス ウインドウで、お使いのハードウェアでの実際の速度を確認できます。
- 最初のリクエストでは、モデルをメモリに読み込む時間 がかかります。
- 以降のターンは軽くなります。 エンジンは会話ごとのプロンプトキャッシュを保持するので、エージェントの各ターンでは新しいトークンだけが処理されます。
- 生成は直列化されます。 エンジンは一度に 1 つの生成しか実行しません。忙しいセッションが複数あると、並列に動くのではなく GPU を分け合います。
ローカル推論の監視
ウインドウ メニューの 2 つのウインドウで、Console.app を使わずにローカル推論を監視できます。
推論メトリクス
ウインドウ › 推論メトリクス… は、使用中のエンジンごとにタブを持つライブのテレメトリウインドウ(推論メトリクス)を開きます――組み込みエンジンと、マシンが指しているすべてのカスタムサーバーです。組み込みのタブは Local inference とエンジンのループバックアドレスを見出しとし、Decode tok/s、Prefill tok/s、Running、Waiting、In flight、Avg latency、Cache hit、Metal mem、Gen tokens、Prompt tokens のカード、読み込み済みのモデル の一覧、そして生データの表を収めた All metrics の折りたたみを表示します。
ウインドウは、開いている間だけ 5 秒ごとに問い合わせます。デコードとプリフィルの速度は通算の平均なので、表示は安定しています。エンジンが停止しているときは engine not reachable と表示され、長い生成の最中には一時的に engine busy (timed out) と表示されることがあります。メトリクスのエンドポイントを公開していないカスタムサーバー(Ollama など)でも、プロキシが中継したトラフィックから計測したカードが表示されます。
推論エンジンログ
ウインドウ › 推論エンジンのログ… は、エンジンの出力とライフサイクルイベント――モデルの読み込み、「serving」、リクエストごとの統計、メモリ不足、クラッシュ、再起動、読み込みエラー――をリアルタイムで追うウインドウ(推論エンジンのログ)を開きます。行は色分けされています(失敗は赤、正常なイベントは緑、警告はオレンジ、処理中の作業は青)。ツールバーには フィルタ… フィールド、自動スクロール チェックボックス、コピー、クリア があり、まだ何も記録されていないときは No inference-engine activity yet と表示されます。バッファには最後の 5,000 行が保持され、すべての行はアプリの標準エラー出力にも書き込まれます。
ヒント: ローカルモデルが遅い、または止まったように感じたら、まず 推論エンジンのログ を開いてください。モデルの読み込み、追い出し、メモリ不足による再起動、未対応アーキテクチャのエラーは、すべてそこにプレーンテキストで表示されます。
コマンドラインリファレンス
model コマンドはオンデバイスモデルを管理し、実行中のアプリと通信します。マシンに対して作用するコマンドは、末尾に <vm> 引数――VM の ID またはワークスペース名――を取ります。周辺のコマンド群については CLI、API、MCP を参照してください。
bromure-cli model catalog [--all] [--offline]
bromure-cli model pull <catalog-id | org/repo>
bromure-cli model ls
bromure-cli model use <catalog-id | org/repo> <vm>
bromure-cli model rm <catalog-id | org/repo>
bromure-cli vm routing cloud|local <vm>
| コマンド | 動作 |
|---|---|
model catalog | カタログのモデルを、適合とツール呼び出しのバッジ、インストール済みのチェックマーク付きで一覧表示し、Mac のユニファイドメモリ量を表示します。最初に公開カタログを更新します(失敗しても致命的ではありません)。--all は収まらないモデルも含め、--offline は同梱とキャッシュ済みのカタログだけを使います。 |
model pull | カタログ ID または任意の Hugging Face の MLX リポジトリでモデルをダウンロードします。MLX(GGUF ではない)であることとディスク容量を確認したうえで、進捗バーを表示します。 |
model ls | インストール済みのモデルをディスク使用量とともに一覧表示します。 |
model use | 実行中の マシンのエージェントが使うローカルモデルを、エージェントを再起動せずに設定します。カスタムサーバーを使うマシンでは、サーバーが受け付ける任意の ID が使えます。 |
model rm | インストール済みのモデルの重みを削除します。 |
vm routing | 実行中の マシンを、クラウドとローカルのルーティングの間で切り替えます。 |
model use と vm routing は、実行中のマシンに対するその場限りの調整です。マシンのモデルを設定するのはモデルボードであり、次にマシンを起動したときに適用されるのもモデルボードの設定です。
内部診断コマンド
これらの隠しサブコマンドは、開発とトラブルシューティングのためのものです。
| コマンド | 目的 |
|---|---|
bromure-cli model _mlx-serve <repo> | 1 つのモデルの MLX サーバーを起動してブロックし、curl でテストするためのポートとキーを表示します。 |
bromure-cli model _mlx-selftest <repo> | モデルを読み込んで 1 回生成し、最初のトークンまでの時間とデコード速度を表示します。 |
bromure-cli model _repair-serve --engine-port <port> | 実行中のエンジンに対して、ツール呼び出しの修復プロキシを単独で実行します。 |
bromure-cli model _tc-test <path> | 保存したテキストファイルに対して、ツール呼び出しの救出を実行します。 |
bromure-cli model _spec-bench <main-repo> --draft <draft-repo> | モデルペアについて投機的デコーディングのオフとオンをベンチマークします。 |