个人数据保护
编码代理会把你相当多的数据送到它的模型提供方:它读过的每个文件、每一次命令输出、它看过的数据库导出或 CSV 的每一行,都会进入对话。当那些数据含有个人信息——客户姓名、邮箱地址、电话号码、卡号、街道地址——提供方也会收到它们。
个人数据保护把那些个人数据留在你的 Mac 上。在一个请求出发前往模型提供方之前,主机端的代理服务器会在其中找出个人数据,并把每个值换成一个逼真的替身:真名换成编出来的名字,真实邮箱地址换成 @example.com 的地址,依此类推。回复回来时,代理服务器会把真实值放回去。提供方看到的永远只是替身;代理、你的文件与你的终端仍然使用真实值运作,而代理从不看到替身。
检测在设备上以内置的 Rampart 模型运行。不会有任何东西被送到别处去扫描。
本章说明这项功能会换掉什么、替身如何运作、在哪里看到它发挥作用,以及它的限制。个人数据保护是按机器设置的(在设置编辑器中即工作区);字段参考见设置 → 个人数据保护。
开启它
打开机器的设置,并在侧边栏的安全下选择个人数据保护。
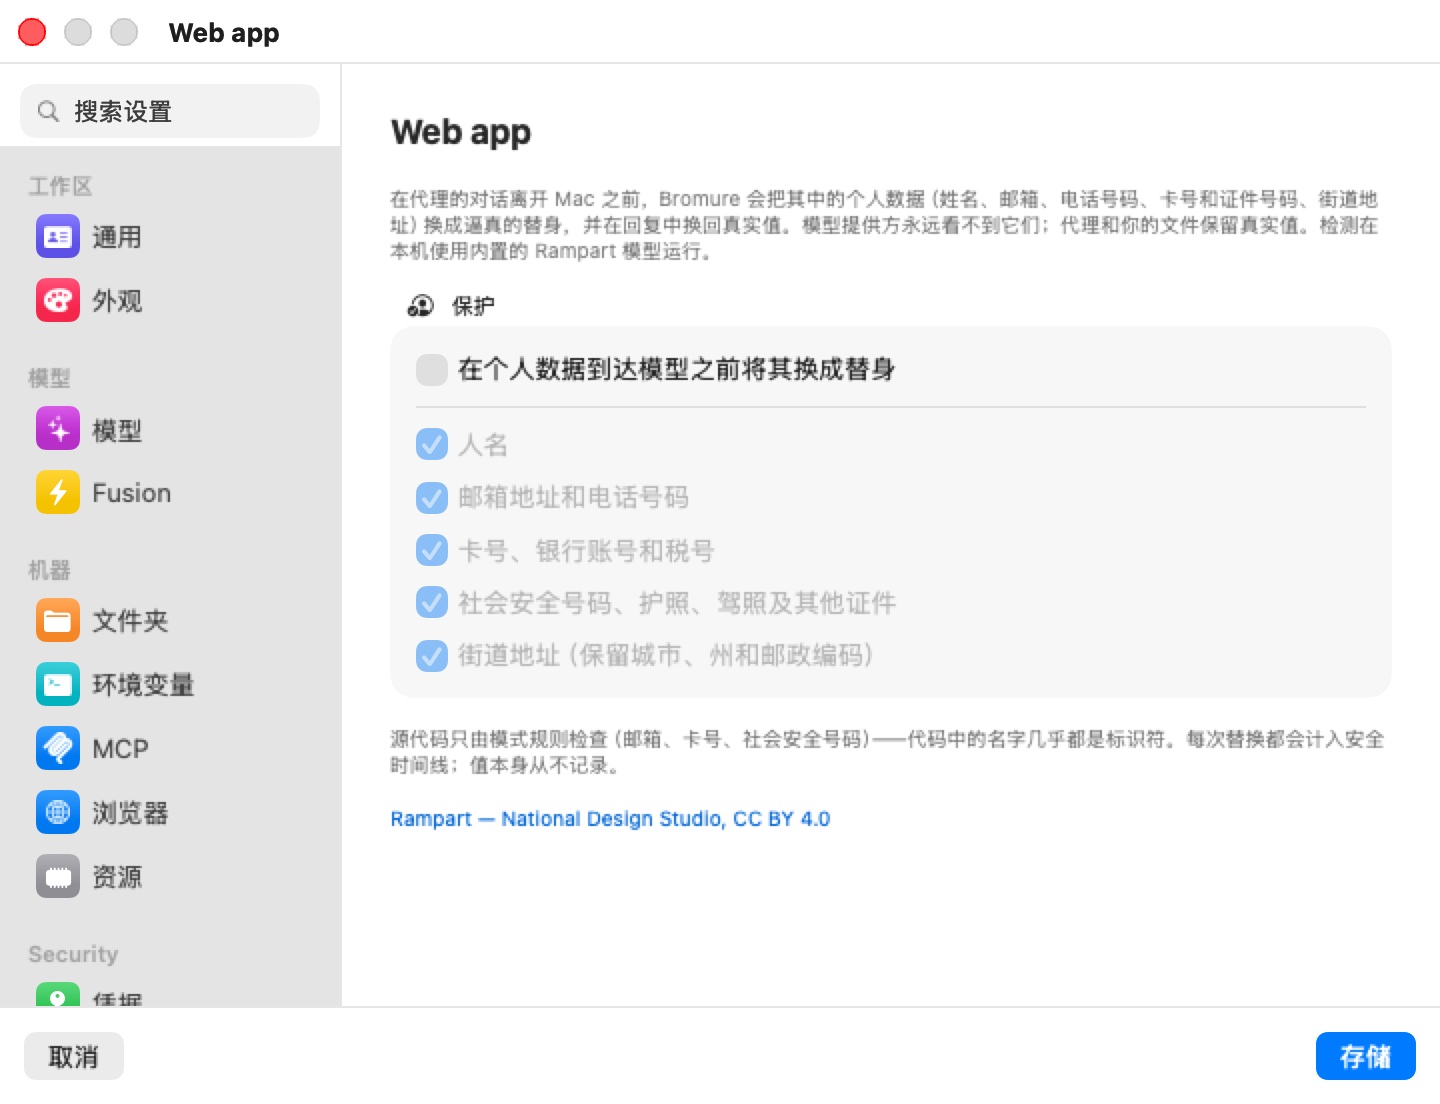
这个窗格有一个分组,防护:
| 设置 | 默认 | 涵盖范围 |
|---|---|---|
| 在个人数据到达模型之前将其换成替身 | 关闭 | 主开关。它关闭时,下方各类别会变灰。 |
| 人名 | 开启 | 名字与姓氏。 |
| 邮箱地址和电话号码 | 开启 | 邮箱地址;至少七位数的电话号码。 |
| 卡号、银行账号和税号 | 开启 | 支付卡号、银行账号与汇款路由号码、税号。 |
| 社会安全号码、护照、驾照及其他证件 | 开启 | 美国社会安全号码与其他政府身份证号。 |
| 街道地址(保留城市、州和邮政编码) | 开启 | 街道那一行(门牌号、街道、单元),整段一起替换。 |
点击存储。这项设置会在该机器的下一次 AI 请求生效。
分组下方,窗格注明源码交由模式规则处理,而每次替换都会计入安全时间线,但值本身从不被记录。Rampart — National Design Studio, CC BY 4.0 链接是检测模型的出处说明。
注意: 检测模型随应用一起出货。在未包含它的构建中,开启这个开关会提议下载它(约 14 MB);若下载被拒或失败,开关会自行回到关闭。
什么会被换掉
检测结合两道处理:
- 模式规则搭配验证器可精确辨识结构化数据:邮箱地址、卡号(以 Luhn 算法检查)、社会安全号码等等。
- Rampart 模型是一个在 Mac 的 CPU 上运行的小型 token 分类器,会在文句与数据中找出非结构化的种类——人名与街道地址。
接着 Bromure 会过滤模型的提议,让一般的代码与产品名称不被误认为人:
- 源码只套用模式规则。 代码中的名字几乎总是标识符,所以代码会被排除在模型那一道之外;代码中的邮箱地址、卡号与社会安全号码仍然会被替换。
- 知名产品、公司与工具的名称(Claude、GitHub、Docker、Postgres…)绝不会被当成人。
- 城市、州与邮政编码会保留,看起来像 URL 或 IP 地址的东西也会保留。地址中只有街道那一行会被替换。
- 一个值绝不跨行,而太短或太像代码、不可能是某人数据的片段会被放过。
只有对话的文字会被改动。代理服务器逐一字符串改写请求,其余每个字节都维持代理送出时的原样。模型的思考、签名与加密内容在任一方向都不会被碰到,所以提供方的完整性检查仍然会通过。
替身如何运作
每个替身看起来都像真的,所以模型仍然可以对那些数据进行推理:
| 种类 | 替身 |
|---|---|
| 姓名 | 一个逼真、可发音的名字 |
| 邮箱 | 一个 @example.com 的地址 |
| 电话号码 | 一个与原本相同格式的号码 |
| 卡号 | 一个能通过 Luhn 检查的测试卡号 |
| 社会安全号码 | 一个位于从未签发的 9xx 区间的号码 |
替身在每台机器内保持一致。同一个真实值永远取得同一个替身——跨回合,也跨应用重新启动——因为每一个都是用该机器专属的密钥从那个值导出的。这有两个意义:
- 代理每回合重发的对话会维持字节完全相同,所以提供方的提示缓存仍然有效。
- 模型在整段对话中看到的是一位一致的人或客户,而不是每回合一个新的随机名字。
每个替身在使用前都会与词典以及所有其他条目比对,这样在回复中把它还原时就不会改动到一般词汇。同时也是日常词汇的名字(“Will”、“Grace”)只会在它被检测为人名的地方被替换。
每台机器专属的密钥位于 ~/Library/Application Support/BromureAC/pii/<工作区 id>.key(权限 0600)。值与替身的对照表从不写入磁盘;随着那些值再次出现,它会在内存中重建。
把真实值放回去
随着回复以流式回来,代理服务器会在代理看到之前,把每个替身换回它的真实值——在文字中,也在工具调用的参数中,所以代理写的文件或执行的命令拿到的是真实数据。回复的还原适用于 Anthropic Messages API、OpenAI 的 Chat Completions 与 Responses API,以及 Gemini,无论是流式或整批送出。流式时,代理服务器会一次保留几个字符,让被切在两个块之间的替身仍然能被辨识。
适用范围
个人数据保护作用于代理送往云端 AI 提供方的请求——即追踪能捕获正文的那些已知 AI 主机,HuggingFace 除外——而且必须是该请求带有对话时。它不适用于:
- 设备端模型。 由 Mac 自己的推理引擎处理的回合从不离开这台 Mac,因此不会被改写。
- 经压缩的请求正文。 客户端已把正文压缩的请求会不经扫描直接通过。
因为替换发生在 Fusion 把问题分发出去之前,所以 Fusion 面板上的其他模型同样收到替身。
看它发挥作用
每一个有新值被替换的请求,都会在安全时间线中加上一行个人数据保护:各类型的计数与目标主机(例如 3 个姓名 · 1 个电话号码 → api.anthropic.com),判定为已换成替身。这些行只带计数——值本身从不被记录。先前回合已替换过、随历史一起重发的值不会再被计入。对模型预算而言过大的请求会得到一行判定为部分——已达模型预算;仅套用模式规则,即使什么都没被替换也一样。
概览标签页的已替换的个人数据磁贴会汇总最近 24 小时替换掉的值,而防护表格有一个个人数据保护列,显示哪些机器开启了这项功能。
限制
- 这是检测,不是保证。 这个模型牺牲了一点召回率,换来在代码上大幅减少的误判;不寻常的格式、处于不寻常情境中的名字,或源码里的个人数据,都可能通过。请把它当成大幅降低暴露,而不是“没有任何个人数据送到提供方”的证明。
- 非常大的请求有一部分只套用模式。 模型每个请求最多读取 300,000 个字符的新文字,由新到旧;超出这个预算的部分只会套用模式规则,而安全时间线会把该请求记为“部分——已达模型预算;仅套用模式规则”。更早的历史在先前的回合就已处理过。
- 只有对话的文字会被改动。 图片、以二进制数据送出的文件附件,以及像 id 与模型名称之类的字段都不会被扫描。
- 追踪记录保留真实值。 当追踪捕获 AI 正文时,保存的请求是代理送出的那一份,保存的回复是还原后的那一份,所以两者都含有真实值——就像每一份追踪正文一样,在你的 Mac 上经过加密。提供方收到的替身版本并不会被保存。