模型与提供方
Bromure Agentic Coding 中的每个编程代理——Claude Code、Codex、Grok、Kimi 和 omp——都从同一个地方获取模型和凭据:模型 看板。每个来源只需注册一次(云提供方的登录或 API 密钥、Amazon Bedrock、OpenRouter、你自己的推理服务器,或在这台 Mac 上运行的模型),每台机器都能使用。机器(在设置编辑器中称为工作区)默认继承这些全局设置,也可以覆盖其中任何部分。
本章涵盖看板本身、登录与登出、按代理选择模型、机器专属覆盖、代理如何连接到非自家的提供方、更改设置时正在运行的代理会发生什么,以及内置的设备端引擎:它的目录、下载、监控窗口和 model 命令。工作区面板的逐栏列表,请参阅模型设置。Fusion——多个模型回答同一个提示——是另一项有自己面板的功能。
注: 旧版本有工作区专属的 代理 面板、本地模型 面板,以及会从云端回退到本地模型的“混合”路由模式。这三者都已移除。模型和凭据的选择都在模型看板上,而机器的流量会按代理发往云端或本地后端,如下所述。
模型看板出现的位置
同一个双栏看板会出现在四个地方:
| 位置 | 编辑的内容 | 更改何时生效 |
|---|---|---|
| 偏好设置 › 模型(⌘,) | 每台机器都会继承的全局设置。 | 立即——看板会随着编辑实时保存,与偏好设置窗口的 存储 按钮无关。 |
| 机器的设置编辑器 › 模型 | 该机器对全局设置的覆盖(请参阅机器专属覆盖)。 | 在编辑器中点按 存储 时。 |
| 引导向导的 模型 步骤 | 全局设置,仅限首次运行。 | 立即。 |
| 镜像的远程 Mac 的偏好设置(设置对象: 某台远程主机) | 该 Mac 的全局设置,通过隧道获取,API 密钥会被遮蔽。 | 点按 存储 时。请参阅远程访问。 |
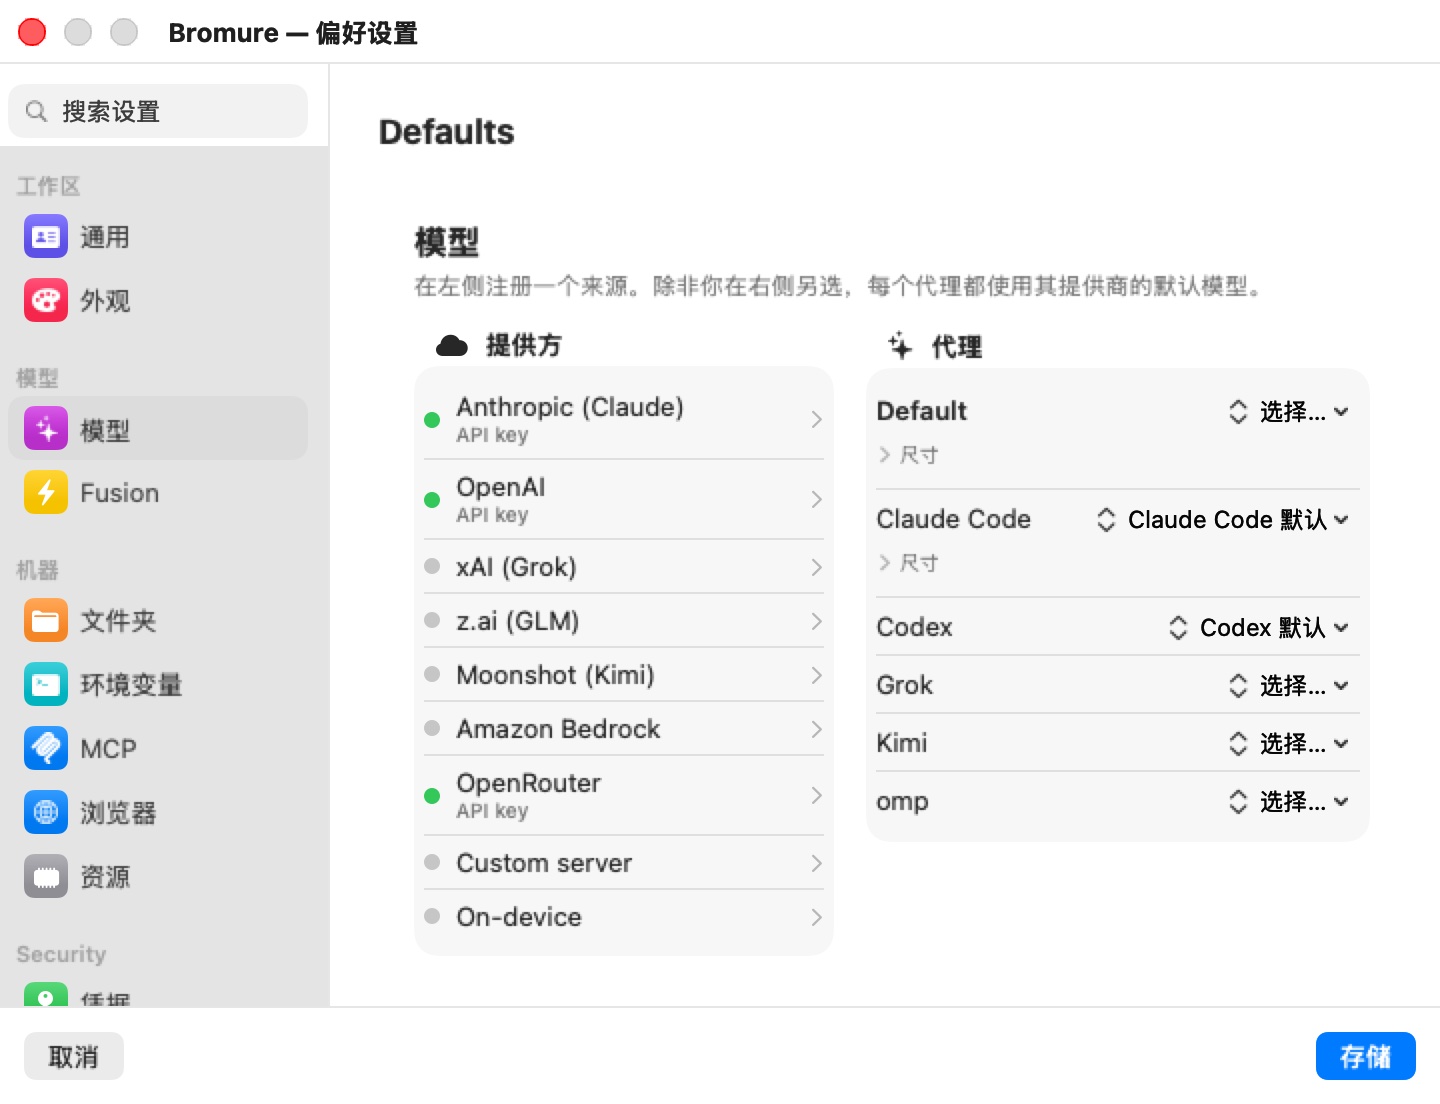
面板的标题是 模型,说明文字为“在左侧注册一个来源。除非你在右侧另选,每个代理都使用其提供商的默认模型。”左侧是 提供方 栏,右侧是 代理 栏。
提供方
提供方 中的每一行都有一个状态点和一行副标题。绿色表示可用;灰色表示未配置;橙色表示订阅登录已过期。点按一行即可打开其配置弹出窗口。
| 提供方 | 配置方式 | 注 |
|---|---|---|
| Anthropic (Claude) | 订阅登录或 API 密钥 | Claude Code 的原生提供方。 |
| OpenAI | 订阅登录或 API 密钥 | Codex 的原生提供方。 |
| xAI (Grok) | 订阅登录或 API 密钥 | Grok 的原生提供方。 |
| z.ai (GLM) | 仅 API 密钥 | z.ai 的编程套餐以 API 密钥提供;没有需要登录的地方。 |
| Moonshot (Kimi) | 订阅登录或 API 密钥 | Kimi 的原生提供方。 |
| Amazon Bedrock | 使用 Amazon Bedrock、可选的区域和可选的 API 密钥 | 请参阅 Amazon Bedrock。 |
| OpenRouter | 仅 API 密钥 | 其模型列表会实时从 OpenRouter 获取。 |
| 自定义服务器 | 服务器 URL 和可选的 API 密钥 | 任何与 OpenAI 兼容的服务器。请参阅自定义服务器。 |
| 设备端 | 下载模型 | MLX 模型在这台 Mac 的 GPU 上运行。请参阅设备端模型。 |
行的副标题会说明提供方的配置方式:API key、subscription、登录已过期、AWS 凭据(Bedrock)、主机名(自定义服务器)或 N installed(设备端)。在机器的覆盖中,也可能显示 inherited API key、inherited subscription、overridden here 或 off here。
登录与 API 密钥
对于 Anthropic、OpenAI、xAI 和 Moonshot,弹出窗口一开头是 Sign in with 提供方(“在临时虚拟机中交互式登录——无需 API 密钥。”),接着在 API 密钥 字段上方显示“或粘贴 API 密钥”。两者都没有时,会显示 尚未配置。
登录会在一台用完即弃的 VM 中运行提供方自己的 CLI 登录;提供方的页面会在你的浏览器中打开,捕获到的登录会保存在主机上,绝不会存放在机器中。登录后,弹出窗口会显示 已登录 及距今多久,另有 重新登录… 和 登出…。登出… 会要求确认——“要登出 提供方 吗?”、“使用此登录的工作区将停止工作,直到你重新登录。”——并提供 登出/取消。
如果提供方拒绝了已保存的登录(例如在别处已被撤销),弹出窗口会切换为橙色的 登录已过期 面板,说明在你重新登录之前会话都无法使用它,并附上醒目的 重新登录 按钮。
对同一个提供方而言,粘贴的 API 密钥优先于订阅:输入密钥会把该提供方切换为按用量计费。密钥会加密保存(请参阅设置的保存位置)。
注: 订阅只能驱动它自己的代理——Claude 订阅驱动 Claude Code,ChatGPT 订阅驱动 Codex,以此类推。因此以订阅登录的提供方绝不会出现在其他代理的模型菜单中,也不能用在 Default 行。API 密钥则没有这项限制。
订阅范围:所有机器或仅一台
从 偏好设置 › 模型 开始的登录,一律由所有机器共享。从机器的设置编辑器(其 模型 面板)开始的登录,最后会询问一个问题:要与每个工作区共享吗?——“要把这个 提供方 登录用于所有 Bromure 工作区(替换各工作区自己的 提供方 登录),还是只用于这一个?”——并提供 每个工作区 和 仅此工作区。
- 每个工作区 会把此登录保存为共享登录,并移除任何机器对该提供方的专属登录,让新的登录确实成为每台机器使用的登录。
- 仅此工作区 只为那台机器保存。拥有自己登录的机器始终优先使用自己的,而非共享的登录。
如果登录是从镜像的远程 Mac 开始,而没有人回答这个问题,默认选择为 仅此工作区。
Amazon Bedrock
Bedrock 弹出窗口说明:“任何代理都能在 Amazon Bedrock 上运行:Claude Code 原生支持,其他代理则通过 Bedrock 与 OpenAI 兼容的 API。请用每个工作区自己的 AWS 凭据(凭据 → AWS)签名请求,或粘贴 Bedrock API 密钥。”
- 打开 使用 Amazon Bedrock。
- 根据需要设置 AWS 区域。留空时,每台机器会使用其自身 AWS 凭据的区域,若没有则使用
us-east-1。 - 根据需要粘贴 Bedrock API 密钥(可选——否则由 AWS 凭据签名)。没有密钥时,主机会用机器凭据面板中的 AWS 凭据签名每个请求;凭据永远不会进入 VM。
启用 Bedrock 会用一个 Bedrock Claude 模型 ID 预先填入 Claude Code 的主模型。模型 ID 就是 Bedrock 使用的 ID(例如 us.anthropic.claude-sonnet-4-6);可在菜单中为每个代理挑选,或用 自定义 ID… 自行输入。Bedrock 没有列出模型的端点,因此菜单提供一份精选的简短列表。
没有 API 密钥的 Bedrock 代理,只有在具备 AWS 凭据的机器上才能启动。关闭 使用 Amazon Bedrock 会清除所有指向 Bedrock 的模型选择,让这些代理回到默认值。
自定义服务器
自定义服务器 是任何与 OpenAI 兼容的推理服务器——vLLM、Ollama、LM Studio、llama-server——位于这台 Mac 或你网络上的其他地方。弹出窗口称它为“Recommended for local models.”
- 打开 已启用。
- 输入 服务器 URL(例如
http://127.0.0.1:11434/v1),如果服务器需要,再输入 API 密钥(可选)。 - 点按 测试连接。成功时会显示 N model(s),服务器的模型会出现在每个代理菜单的 自定义服务器 之下;失败时则显示服务器的错误。
使用自定义服务器时,模型 ID 就是服务器自己的 ID,原样使用(例如 qwen3:32b)。主机的修复代理服务器会把每个代理的线上格式(Anthropic messages、OpenAI chat、OpenAI responses)与服务器的 /v1/chat/completions 互相转换,而模型的上下文窗口、视觉和推理支持都会向服务器探询后传给代理。使用自定义服务器时,不会在 Mac 上启动任何引擎进程。
设备端模型
设备端 会打开目录模型列表——“MLX models run in-process on this Mac (N GB) — the lazy backup, nothing to install.”每一行显示模型名称、一个适配徽章(Fits、Tight 或 Won't fit)和下载大小,以及一个操作:
| 控件 | 含义 |
|---|---|
| 获取 | 下载模型。模型放不进这台 Mac 时会停用。 |
| 进度条 + ✕ | 下载中;✕ 会取消并删除部分下载的内容。 |
| 恢复 | 中断的下载(应用退出或崩溃);从中断处继续。 |
| 重试 | 下载失败;把指针移到上面即可看到原因。 |
| 移除 | 已安装;移除权重,并清除任何使用它们的模型选择。 |
已安装的模型会出现在每个代理菜单的 设备端 之下。下载由所有机器共享。目录、适配规则和引擎在设备端引擎中说明。
代理:选择模型
代理 栏有一行 Default,接着每个代理各一行:Claude Code、Codex、Grok、Kimi 和 omp。每一行都有一个模型标签;点按即可选择。
标签显示的内容:
- 代理 default——没有选择任何东西,且该代理自己的提供方已配置,因此代理运行该提供方的默认模型,与它自己
/model的“Default”完全相同。你不需要选任何东西。 - 选择…——没有选择任何东西,这个代理也解析不到任何模型。
- 一个模型 ID,并以彩色圆点标示其来源(蓝色:云提供方;薄荷绿:自定义服务器;紫色:设备端;橙色、加删除线并标记 · 不可用:这个代理无法连接的提供方——请参阅哪个代理能连接哪个提供方)。ID 后的 · 继承 表示该值来自 Default 行(在机器覆盖中则来自全局设置)。明确选择旁的 ✕ 可以清除它。
标签的菜单会把代理能连接的每个可用提供方,列为模型 ID 的子菜单(一份精选列表,如果提供方有实时模型列表则合并在一起),接着在已配置时列出 自定义服务器 和 设备端。每个提供方子菜单的最后都有 自定义 ID…,会询问“The id exactly as the backend names it (e.g. claude-opus-5, glm-4.6, qwen3-coder).”对于有明确选择的代理,菜单还会提供 使用默认(如果 Default 行未设置任何东西,则为 Use agent’s default)来清除它。
如果菜单没有可提供的项目,它会直接说明:请先配置提供方;如果已配置的提供方全都是该代理连接不到的,则显示 No configured provider can power agent;如果已配置的提供方只有其他代理的订阅,则显示 订阅只能为其自身的代理提供支持。在 自定义服务器 之下,测试连接以列出模型 表示尚未探询服务器。
Default 行
Default 行上的模型会应用到每个没有自己选择的代理——包括自家提供方已配置、否则会使用提供方默认模型的代理。如果你希望每个代理都使用自家提供方的默认模型,请让 Default 保持在 选择…。
尺寸
Claude Code 使用三个模型槽位;其他代理都只运行一个模型。Default 和 Claude Code 行有一个 尺寸 折叠区,内含两个额外的标签:
| 尺寸 | Claude Code 槽位 |
|---|---|
| Large | ≈ opus |
| (主标签) | ≈ sonnet |
| Small | ≈ haiku(后台和快速任务) |
未设置时,大、小槽位会沿用 Claude Code 自己的默认值。其中之一已设置时,尺寸 会自动展开。在 Claude Code 行上,恢复默认 会舍弃 Claude Code 自己的所有选择,让它重新继承 Default 行。Codex、Grok、Kimi 和 omp 只使用主标签。
哪个代理能连接哪个提供方
每个代理都能原生连接自家的提供方。它也可以被指向其他一些提供方,由主机替它桥接:
| 代理 | 原生提供方 | 也能连接 |
|---|---|---|
| Claude Code | Anthropic(订阅或密钥) | Amazon Bedrock(Claude Code 自己的 Bedrock 模式);OpenRouter 和 z.ai(直接通过它们与 Anthropic 兼容的端点,API 密钥);自定义服务器;设备端 |
| Codex | OpenAI | Amazon Bedrock、OpenRouter、xAI、Moonshot(通过主机的修复代理服务器,API 密钥);自定义服务器;设备端 |
| Grok | xAI | Amazon Bedrock、OpenRouter、Moonshot(修复代理服务器);自定义服务器;设备端 |
| Kimi | Moonshot | Amazon Bedrock、OpenRouter、xAI(修复代理服务器);自定义服务器;设备端 |
| omp | Anthropic,仅 API 密钥 | Amazon Bedrock、OpenRouter、xAI、Moonshot(修复代理服务器);omp 本身切换到 z.ai 时的 z.ai;自定义服务器;设备端 |
走修复代理服务器路径时,VM 内的代理与主机通信,由主机转换代理的线上格式、持有真正的密钥(或为 Bedrock 签名)并转发请求。密钥永远不会进入 VM。Claude Code 的 OpenRouter 和 z.ai 路径则是让代理直接指向提供方与 Anthropic 兼容的端点(https://openrouter.ai/api、https://api.z.ai/api/anthropic),并使用一把替代密钥,由主机在传输途中换成真正的密钥,与处理每个云凭据的方式相同(请参阅凭据与传输边界)。
代理的模型菜单只会提供它能连接的提供方。Claude Code 只懂 Anthropic 方言,因此其菜单中没有 OpenAI、xAI 或 Moonshot 模型;z.ai 与 OpenAI 兼容的 API 并不是其他代理能被桥接过去的 API,因此 Claude Code 的菜单是唯一提供 z.ai 模型的代理菜单(切换到 z.ai 的 omp 则能自行连接)。
在变得无法连接之前就已保存的选择——或被无法使用它的代理从 Default 行继承的选择——会以橙色、加删除线的方式显示,后面加上 · 不可用。其工具提示说明:“Agent can’t use provider models, so it runs on its own provider instead. Pick another model.”
omp 在看板上没有自己的提供方,也无法使用订阅;请给它一个基于 API 密钥的提供方。
机器专属覆盖
机器的设置编辑器有一个 模型 面板(位于 模型 组下)。默认会显示一个关闭的开关 此工作区的自定义模型设置——“Inheriting the global settings (Preferences → Models).”——以及一份 继承的模型 摘要:全局的 Large / Medium / Small 模型和已配置的提供方。
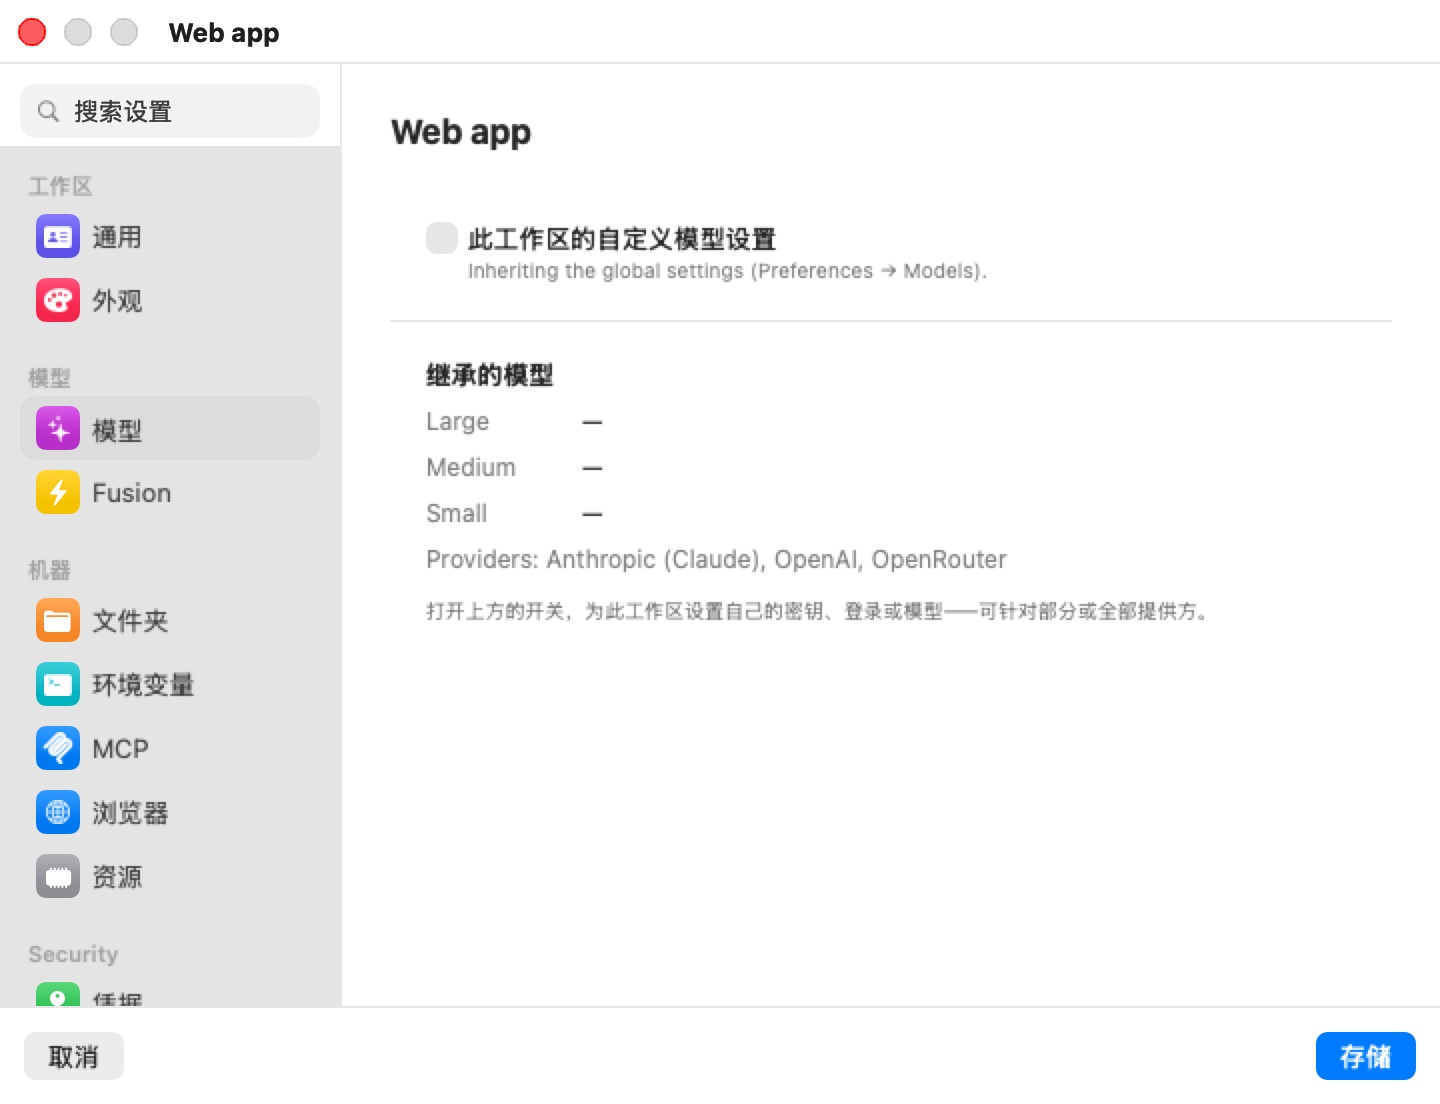
打开开关并选择两种模式之一:
- 继承并修改(默认)——“Starts from the global settings; only what you set below is different here.”会显示完整的看板,在全局设置之上叠加这台机器的更改。你没改动的任何部分都会持续实时跟随全局设置——之后在全局注册的提供方也会出现在这里。
- 独立——“This workspace has its own providers, logins and model choices below — the global settings are ignored.”切换为独立时,会从当前生效设置的副本开始,因此在你编辑之前不会有任何改变。
在 继承并修改 模式下,每个提供方弹出窗口都会说明该提供方的来源,并让你只针对这台机器更改:
| 标签 | 含义 |
|---|---|
| Inherited from Preferences → Models (API key / subscription / AWS credentials). | 使用全局凭据。不在此工作区中使用 可以退出,“— or override it below”则用这台机器自己的密钥或登录覆盖。 |
| Not used in this workspace — the global settings have it. | 你已退出。使用全局提供方 会重新加入。 |
| This workspace's own credential. | 这台机器有自己的密钥或登录。使用全局提供方 会舍弃它。 |
| This workspace's own server. / 使用全局服务器 | 自定义服务器的对应项。 |
模型标签的工作方式与全局看板相同;未更改的标签会显示 · 继承,而清除明确的选择会让它回到全局值(使用全局设置)。
点按 存储 时,覆盖会随机器一起保存。在覆盖中输入的密钥,会与机器的其他机密一起加密保存。
在运行中的机器上更改模型
更改模型或凭据时,永远不需要重启机器。当你注册提供方、粘贴或更改密钥、登录或登出、把代理改用其他模型,或保存机器覆盖时:
- 主机会为每台运行中的机器,更新该机器代理读取的内容——凭据替换映射、代理的环境和配置文件。
- 凭据或模型确实有变的每个代理,都会在自己的标签页中停止,并立即带着恢复参数重新启动,因此对话会继续。在聊天视图中,会话会保留其记录;在终端中,你会看到代理退出后立刻回来。
- 设置没有更改的代理不受影响,VM 本身也绝不会重启。
- 机器的 Fusion 设置也会跟随相同的设置:其各分支和评审会重新评估,如果剩下的可用模型少于两个,⚡ 开关会被解除。
全局看板上的更改会在你停止输入约一秒半后应用。
警告: 重启代理会中断它当下正在做的事。如果代理正处于一个很长的回合中,请等它完成后再切换其模型或凭据。
设置的保存位置
全局设置保存在 ~/Library/Application Support/BromureAC/models.enc,使用与工作区机密保险库相同的密钥加密。机器的覆盖随机器一起保存,其密钥则放在加密的机密存储中。订阅登录由主机端的凭据代理服务器保管,按上述选择为共享或机器专属。这些机密都绝不会拷贝到 VM 中:代理拿到的是替代值,由主机在传输途中替换。
限制
- 只有 Anthropic、OpenAI、xAI 和 Moonshot 提供订阅,而且每个订阅只驱动它自己的代理。
- omp 只使用 API 密钥。
- 自定义服务器必须与 OpenAI 兼容。
- 在同一台机器中,所有在本地运行的代理(自定义服务器或设备端)共用单一本地模型:以主代理的选择为准。
- 设备端引擎使用 Mac 唯一的 GPU,一次只运行一个生成。
- iPhone、iPad 或 Apple Vision Pro 上的 Bromure Remote 无法使用模型看板;请在 Mac 上编辑模型。
设备端引擎
设备端引擎使用 Apple 的 MLX 框架,在你 Mac 的 GPU 上运行开放权重的编程模型——无需往返云端,没有按词元计费,也没有代码离开 Mac。没有需要安装的东西,没有 Python 环境,也没有需要配置的服务器。
注: 推理在 Mac 上运行,而不是在 VM 内。浏览器可选的 Metal 图形设备不会为 Linux 提供 GPU 计算或 MLX 访问,因此客户机要跨越传输边界才能连接到引擎。需要 Apple Silicon——与应用本身的要求相同。
引擎进程
MLX 引擎作为应用自身可执行文件(bromure-ac model _mlx-engine)的受监督子进程运行,而不是在应用内。加载对 Mac 内存而言过大的模型,只会终止引擎子进程,绝不会影响应用或其运行中的 VM。应用会自动重启崩溃的引擎,最多三次;之后会放弃,并写下日志行 engine child crashed repeatedly — giving up (a model likely OOMs this Mac)。应用退出时会终止子进程,而强制崩溃留下的孤儿进程会在下次启动时回收。
一个引擎服务所有机器。它绑定到 127.0.0.1 上由内核分配的回环端口——绝不是 0.0.0.0,也绝不是 Ollama 惯用的 11434,因此另外安装的 Ollama 或 LM Studio 仍可正常工作。它能在内存预算内(Mac 的统一内存减去一些余量)保留多个模型,每个模型在第一次使用时加载,内存紧张时则逐出最久未使用的模型。
引擎预热期间,机器的工具栏会显示一个带转圈图标的小型 CPU 徽章(“Starting local engine…”);模型就绪后会变成绿色,如果引擎启动失败则变成橙色(把指针移到上面即可看到原因)。
客户机如何连接到它
VM 中的代理永远不会直接与引擎通信。它们以没有真实 DNS 的合成主机 https://bromure.llm 为目标:主机端代理服务器会拦截它,应用与云流量相同的提示注入扫描和跟踪捕获,再把请求转发给引擎。本地推理绝不会是盲点。
代理配置的是引擎实际提供的模型 ID(例如 mlx-community/Qwen3-8B-4bit-DWQ),因此它们的上下文大小估算和功能查询看到的都是真实情况。
注: 架构尚未被 MLX 引擎支持的模型,会以清楚且永久的错误失败——“its architecture … isn't supported by the on-device engine yet — pick a different model”——并作为客户端错误返回,让代理不会在循环中不断重试。这类模型请使用自定义服务器。
目录
目录是一份精选的、预先转换好的 MLX 模型列表,每个模型都针对代理式编程中最重要的一点——可靠的工具调用——做过验证,并记录了下载大小和所需的最少统一内存。
应用内附一份基准目录,因此列表从第一天起就能离线使用。应用会从 https://dl.bromure.io/mlx/catalog.json 获取更新的目录;较新的已发布目录会替换基准目录,而不是与它合并。从已发布目录中移除的模型会从列表中消失,除非你已经安装了它。
内附的目录包含四个 Qwen3 模型,全都通过工具调用验证:
| 模型 | 下载大小 | 最少统一内存 | 建议 |
|---|---|---|---|
| Qwen3 8B (4-bit DWQ MLX) | 4.3 GB | 16 GB | 是 |
| Qwen3-Coder 30B-A3B (4-bit DWQ MLX) | 17 GB | 32 GB | 是 |
| Qwen3-Coder-Next 80B-A3B (mxfp4 MLX) | 42 GB | 96 GB | 是 |
| Qwen3-Coder 480B-A35B (4-bit MLX) | 270 GB | 512 GB | 否 |
更新的目录可能在不更新应用的情况下,加入更新或更大的版本。
适配徽章
每个模型都会根据你的 Mac 的统一内存来判断:
- Won't fit——模型的最低要求超过你的内存。该行会变淡且无法下载。
- Tight——可以加载,但留给其他一切的空间少于 16 GB。
- Fits——最低要求加上 16 GB 余量放得下。
例如,Qwen3 8B(最低 16 GB)在 16 GB 的 Mac 上显示 Tight,在 32 GB 以上则显示 Fits。
下载与存储
权重通过内置的下载器直接来自 huggingface.co——无需 Python,也无需转换。每个权重文件都会流式写入一个临时的 .partial 文件,完成后再重命名到位,因此中断的下载会逐个文件恢复,部分下载的内容也绝不会被误认为已安装的模型。仓库中的文档、图片和 GGUF 文件会被跳过。系统会先检查磁盘空间,并在填满你的磁盘之前就及早失败:
Not enough disk space: 40 GB free, but about 270 GB is needed.
模型按仓库存放在:
~/Library/Application Support/BromureAC/models/<org>--<name>/
其他工具已缓存在 ~/.cache/huggingface/hub 中的模型,会通过硬链接一次性迁移到这个目录,因此不会重复下载。
任何已经是 MLX 格式的 Hugging Face 仓库,也能从命令行用其 org/repo 名称获取(请参阅命令行参考);这样的模型未经测试——不保证工具调用或内存适配。GGUF 仓库会被拒绝,因为 GGUF 是 Ollama 和 llama.cpp 的格式,而不是 MLX:
That's a GGUF (Ollama/llama.cpp) model — Bromure serves MLX weights only.
流式传输、思考与视觉
本地回合会逐个词元流式传输,无论是设备端引擎还是自定义服务器都一样。代理服务器会在文本生成时随即转发,只保留尾部足以剥除泄漏工具调用的部分,然后以修复后的结果完成该回合。
推理模型会在每种线上格式中以原生思考块流式传输其思考内容,因此代理会以呈现云模型思考的方式呈现它;思考内容不会回馈到记录中。支持视觉的模型(向自定义服务器探询得知,或在目录中标记)可以接受图片:代理服务器会在线上格式之间转换图片块。
注: 会话的第一个回合,必须先让模型预填充代理的整个提示——通常是数万个词元的系统提示和工具架构——第一个词元才会出现。在 8B 模型上可能需要一分钟以上;之后的回合会重用引擎的缓存,几乎立即开始。
工具调用修复
量化模型经常把工具调用输出为纯文本,而不是结构化的调用。位于每个本地后端——设备端或自定义服务器——前面的修复代理服务器会缓冲每个响应,并识别泄漏调用可能呈现的多种形式,例如:
<function name="write_file" arguments='{…}'>
<tool_call>{…}</tool_call>
[{"name": "…", "parameters": {…}}]
以及 Qwen3-Coder 原生的 <function=Name><parameter=k>v</parameter></function> 格式和 Gemma 的通道格式。它会把找到的内容转成代理自身线上格式中正确的工具调用。它也会检测宣告了动作(“Now I'll create the file:”)却没有调用工具就停下的模型,并最多再提示两次以取回该调用。本地推理始终开启修复。
引擎的问题会以代理自身线上格式中可读的错误返回给代理,例如:
Local inference engine unreachable (starting up, reloading a model, or stopped) — retry in a moment.
性能预期
- 吞吐量取决于模型和芯片。 像 Qwen3 8B 这样的小模型在任何支持的 Mac 上都很流畅;大型的混合专家(mixture-of-experts)版本较慢,也需要多得多的内存。推理指标 窗口会显示你硬件上的实际速率。
- 第一个请求需要把模型加载到内存。
- 之后的回合比较省。 引擎会为每段对话保留提示缓存,因此代理的每个回合只处理新的词元。
- 生成是按顺序进行的。 引擎一次只运行一个生成;多个忙碌的会话会共用 GPU,而不是并行运行。
监控本地推理
窗口 菜单中的两个窗口,让你不必使用 Console.app 就能观察本地推理。
推理指标
窗口 › 推理指标… 会打开实时遥测窗口(推理指标),每个使用中的引擎一个标签页——内置引擎,加上你的机器所指向的每个自定义服务器。内置标签页以 Local inference 及引擎的回环地址为标题,显示 Decode tok/s、Prefill tok/s、Running、Waiting、In flight、Avg latency、Cache hit、Metal mem、Gen tokens 和 Prompt tokens 卡片、一份 已加载的模型 列表,以及含原始表格的 All metrics 折叠区。
窗口只在打开时每 5 秒轮询一次。解码和预填充速率是整个生命周期的平均值,因此数字很稳定。引擎停止时,窗口会显示 engine not reachable;在长时间生成期间,可能会短暂显示 engine busy (timed out)。没有提供指标端点的自定义服务器(例如 Ollama)仍会有卡片,由代理服务器根据其转发的流量测量而得。
推理引擎日志
窗口 › 推理引擎日志… 会打开引擎输出及其生命周期事件的实时跟踪(推理引擎日志)——模型加载、“serving”、每个请求的统计,以及任何内存不足、崩溃、重启或加载错误。各行以颜色区分(红色为失败,绿色为正常事件,橙色为警告,蓝色为进行中的工作)。工具栏有 筛选… 字段、自动滚动 复选框、拷贝 和 清空;尚未记录任何内容时,会显示 No inference-engine activity yet。缓冲区保留最后 5,000 行,每一行也会写入应用的标准错误输出。
提示: 如果本地模型感觉很慢或卡住,请先打开 推理引擎日志:模型加载、逐出、内存不足导致的重启,以及不支持的架构错误,全都会以纯文本显示在那里。
命令行参考
model 命令用于管理设备端模型;它们与运行中的应用通信。作用于机器的命令,最后会接一个 <vm> 参数:VM ID 或工作区名称。相关的其他命令请参阅 CLI、API 与 MCP。
bromure-cli model catalog [--all] [--offline]
bromure-cli model pull <catalog-id | org/repo>
bromure-cli model ls
bromure-cli model use <catalog-id | org/repo> <vm>
bromure-cli model rm <catalog-id | org/repo>
bromure-cli vm routing cloud|local <vm>
| 命令 | 作用 |
|---|---|
model catalog | 列出目录模型,附上适配和工具调用徽章以及已安装的勾号,并显示你 Mac 的统一内存。会先更新已发布的目录(失败也无妨)。--all 会包含放不下的模型;--offline 只使用内附和缓存的目录。 |
model pull | 按目录 ID 或任何 Hugging Face MLX 仓库下载模型,先确认它是 MLX(而非 GGUF)且磁盘空间足够,并显示进度条。 |
model ls | 列出已安装的模型及其磁盘用量。 |
model use | 设置运行中机器的代理所使用的本地模型,无需重启代理。在使用自定义服务器的机器上,任何服务器接受的 ID 都可以。 |
model rm | 删除已安装模型的权重。 |
vm routing | 在云端和本地路由之间切换运行中的机器。 |
model use 和 vm routing 是针对运行中机器的实时调整;机器的模型是在模型看板上设置的,而下次机器启动时应用的也是看板上的设置。
内部诊断命令
这些隐藏的子命令用于开发和故障排除。
| 命令 | 用途 |
|---|---|
bromure-cli model _mlx-serve <repo> | 为单个模型启动 MLX 服务器并保持运行,打印其端口和密钥,供 curl 测试使用。 |
bromure-cli model _mlx-selftest <repo> | 加载模型、生成一次,并打印首个词元耗时和解码速度。 |
bromure-cli model _repair-serve --engine-port <port> | 针对运行中的引擎,单独运行工具调用修复代理服务器。 |
bromure-cli model _tc-test <path> | 对已保存的文本文件运行工具调用救援。 |
bromure-cli model _spec-bench <main-repo> --draft <draft-repo> | 对一对模型基准测试推测解码关闭与开启的对比。 |