Protection des données personnelles
Un agent de codage envoie une grande quantité de vos données à son fournisseur de modèle : chaque fichier qu'il lit, chaque sortie de commande, chaque ligne d'un export de base de données ou d'un CSV qu'il regarde entre dans la conversation. Quand ces données contiennent des informations personnelles — noms de clients, adresses e-mail, numéros de téléphone, numéros de carte, adresses postales — le fournisseur les reçoit aussi.
La protection des données personnelles garde ces données personnelles sur votre Mac. Avant qu'une requête ne parte vers le fournisseur de modèle, le proxy côté hôte y trouve les données personnelles et remplace chaque valeur par un substitut réaliste : un nom inventé pour un vrai nom, une adresse en @example.com pour un vrai e-mail, et ainsi de suite. Quand la réponse revient, le proxy remet les vraies valeurs. Le fournisseur ne voit jamais que des substituts ; l'agent, vos fichiers et votre terminal continuent de travailler avec les vraies valeurs, et l'agent ne voit jamais de substitut.
La détection tourne sur l'appareil avec le modèle Rampart intégré. Rien n'est envoyé où que ce soit pour être analysé.
Ce chapitre explique ce que la fonction remplace, comment se comportent les substituts, où la voir à l'œuvre, et ses limites. La protection des données personnelles se règle par machine (un espace de travail, dans l'éditeur de réglages) ; la référence des champs est dans Réglages → Protection des données personnelles.
L'activer
Ouvrez les réglages de la machine et sélectionnez Protection des données personnelles sous Sécurité dans la barre latérale.
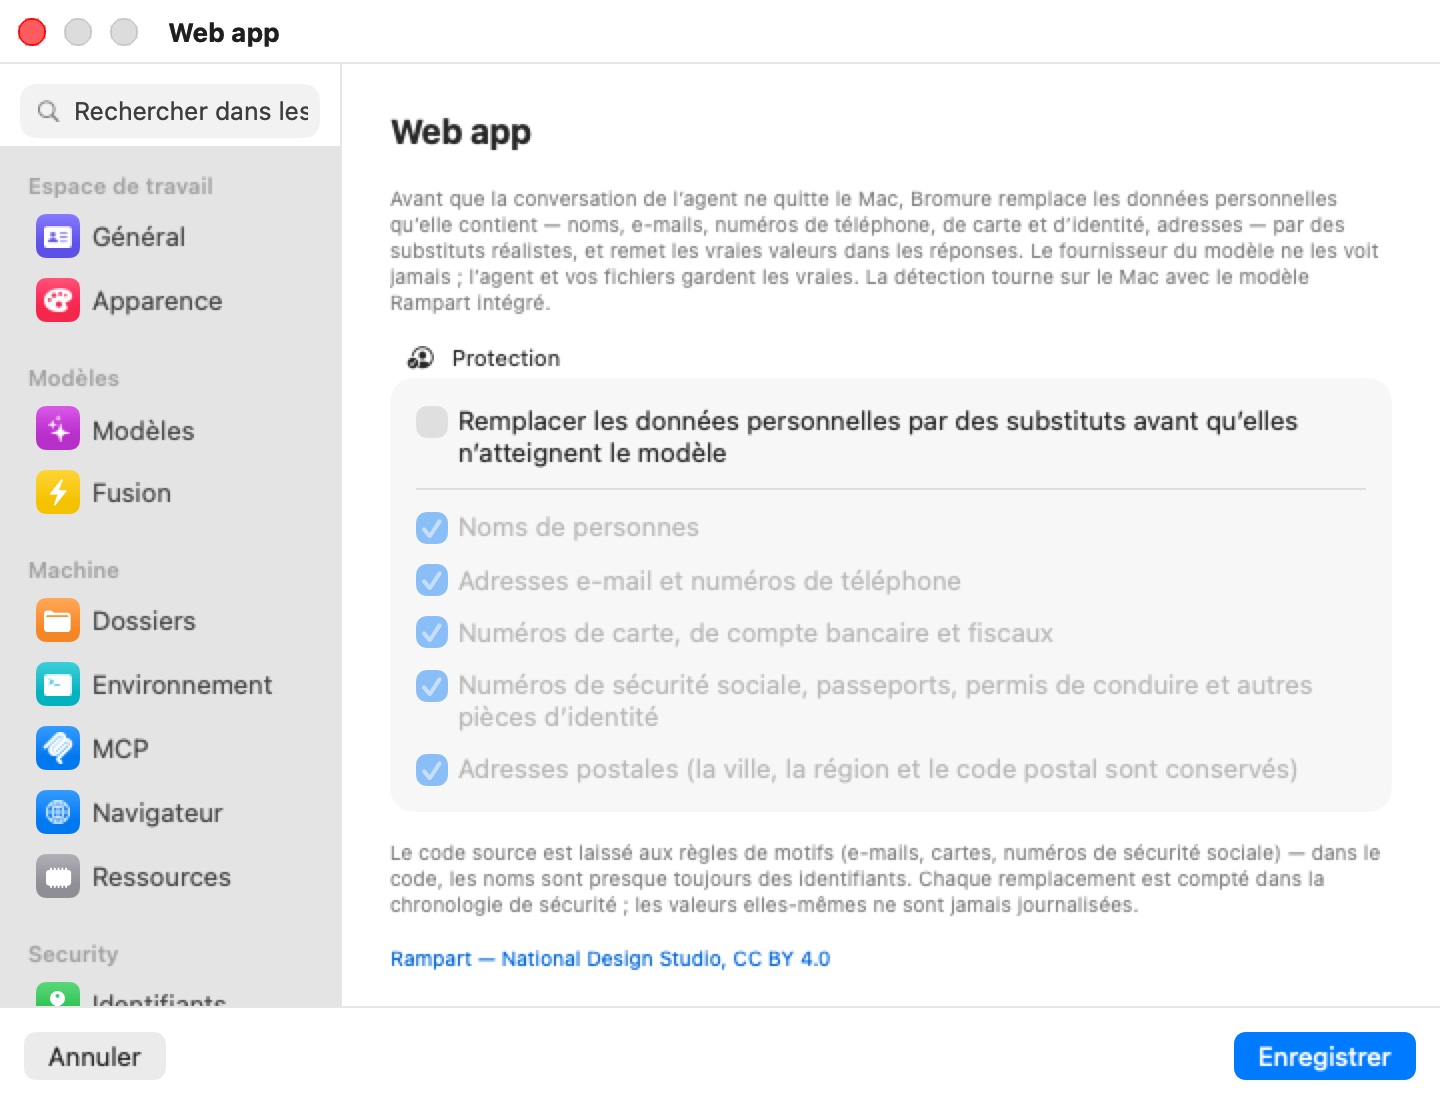
Le volet a un seul groupe, Protection :
| Réglage | Défaut | Ce qu'il couvre |
|---|---|---|
| Remplacer les données personnelles par des substituts avant qu'elles n'atteignent le modèle | Désactivé | L'interrupteur principal. Les catégories en dessous sont grisées tant qu'il est désactivé. |
| Noms de personnes | Activé | Prénoms et noms de famille. |
| Adresses e-mail et numéros de téléphone | Activé | Adresses e-mail ; numéros de téléphone d'au moins sept chiffres. |
| Numéros de carte, de compte bancaire et fiscaux | Activé | Numéros de carte de paiement, numéros de compte bancaire et de routage, numéros fiscaux. |
| Numéros de sécurité sociale, passeports, permis de conduire et autres pièces d'identité | Activé | Numéros de sécurité sociale américains et autres numéros d'identification officiels. |
| Adresses postales (la ville, la région et le code postal sont conservés) | Activé | La ligne de rue (numéro, rue, appartement), remplacée d'un bloc. |
Cliquez Enregistrer. Le réglage prend effet à la prochaine requête IA de la machine.
Sous le groupe, le volet note que le code source est laissé aux règles de motif et que chaque remplacement est compté dans la Chronologie de sécurité sans que les valeurs soient jamais journalisées. Le lien Rampart — National Design Studio, CC BY 4.0 crédite le modèle de détection.
Note : le modèle de détection est livré dans l'application. Dans une version qui ne l'inclut pas, activer l'interrupteur propose de le télécharger (environ 14 Mo) ; si le téléchargement est refusé ou échoue, l'interrupteur se remet de lui-même sur désactivé.
Ce qui est remplacé
La détection combine deux passes :
- Les règles de motif avec validateurs reconnaissent exactement les données structurées : adresses e-mail, numéros de carte (vérifiés avec l'algorithme de Luhn), numéros de sécurité sociale et assimilés.
- Le modèle Rampart, un petit classifieur de jetons tournant sur le CPU du Mac, trouve les types non structurés — noms et adresses postales — dans la prose et les données.
Bromure filtre ensuite ce que le modèle propose, pour que du code ordinaire et des noms de produits ne soient pas pris pour des personnes :
- Le code source ne reçoit que les règles de motif. Les noms dans le code sont presque toujours des identifiants, le code est donc tenu à l'écart de la passe du modèle ; e-mails, cartes et numéros de sécurité sociale dans le code sont tout de même remplacés.
- Les noms de produits, d'entreprises et d'outils bien connus (Claude, GitHub, Docker, Postgres, …) ne sont jamais traités comme des personnes.
- La ville, la région et le code postal sont conservés, ainsi que tout ce qui ressemble à une URL ou une adresse IP. Seule la ligne de rue d'une adresse est remplacée.
- Une valeur ne s'étend jamais sur plusieurs lignes, et les fragments trop courts ou trop proches du code pour être les données de quelqu'un sont laissés tranquilles.
Seul le texte de la conversation est modifié. Le proxy réécrit la requête chaîne par chaîne et laisse chaque autre octet tel que l'agent l'a envoyé. La réflexion du modèle, les signatures et le contenu chiffré ne sont jamais touchés dans un sens ni dans l'autre, si bien que les contrôles d'intégrité du fournisseur passent toujours.
Comment se comportent les substituts
Chaque substitut ressemble à la vraie chose, pour que le modèle puisse encore raisonner sur les données :
| Type | Substitut |
|---|---|
| Nom | Un nom réaliste et prononçable |
Une adresse en @example.com | |
| Numéro de téléphone | Un numéro au même format que l'original |
| Numéro de carte | Un numéro de carte de test qui passe le contrôle de Luhn |
| Numéro de sécurité sociale | Un numéro dans la plage 9xx jamais attribuée |
Les substituts sont cohérents par machine. La même vraie valeur reçoit toujours le même substitut — d'un tour à l'autre et d'un redémarrage de l'application à l'autre — parce que chacun est dérivé de la valeur avec une clé propre à la machine. Cela compte pour deux raisons :
- La conversation que l'agent renvoie à chaque tour reste identique octet pour octet, si bien que la mise en cache de prompt du fournisseur continue de fonctionner.
- Le modèle voit une seule personne ou un seul client cohérent tout au long d'une conversation, pas un nouveau nom aléatoire à chaque tour.
Chaque substitut est vérifié contre le dictionnaire et contre chaque autre entrée avant d'être utilisé, pour que le restaurer dans une réponse ne puisse pas altérer des mots ordinaires. Un nom qui est aussi un mot courant (« Will », « Grace ») n'est remplacé que là où il a été détecté comme un nom.
La clé propre à la machine vit dans ~/Library/Application Support/BromureAC/pii/<id-espace-de-travail>.key (mode 0600). La table des valeurs et des substituts n'est jamais écrite sur le disque ; elle est reconstruite en mémoire à mesure que les valeurs sont revues.
Remettre les vraies valeurs
À mesure que la réponse arrive en flux, le proxy remplace chaque substitut par sa vraie valeur avant que l'agent ne la voie — dans le texte, et dans les arguments des appels d'outils, pour qu'un fichier que l'agent écrit ou une commande qu'il lance reçoive les vraies données. Les réponses sont restaurées pour l'API Anthropic Messages, les API OpenAI Chat Completions et Responses, et Gemini, qu'elles soient en flux ou envoyées d'un bloc. En flux, le proxy retient quelques caractères à la fois pour qu'un substitut coupé entre deux morceaux soit tout de même reconnu.
Où cela s'applique
La protection des données personnelles agit sur les requêtes de l'agent vers les fournisseurs d'IA en nuage — les hôtes d'IA connus dont le traçage peut capturer les corps, HuggingFace excepté — quand la requête porte une conversation. Elle ne s'applique pas à :
- Les modèles sur l'appareil. Un tour servi par le moteur d'inférence du Mac ne quitte jamais le Mac, il n'est donc pas réécrit.
- Les corps de requête compressés. Une requête dont le client a compressé le corps passe sans être analysée.
Comme le remplacement a lieu avant que Fusion n'éclate une question, les autres modèles d'un panneau Fusion reçoivent aussi les substituts.
La voir à l'œuvre
Chaque requête dans laquelle de nouvelles valeurs ont été remplacées ajoute une ligne Protection des données personnelles à la Chronologie de sécurité : les décomptes par type et l'hôte de destination (par exemple 3 noms · 1 numéro de téléphone → api.anthropic.com), avec la décision remplacé par des substituts. Les lignes ne portent que des décomptes — les valeurs elles-mêmes ne sont jamais journalisées. Les valeurs déjà remplacées à un tour antérieur et renvoyées avec l'historique ne sont pas comptées à nouveau. Une requête trop grosse pour le budget du modèle reçoit une ligne avec la décision partiel — budget de modèle atteint ; règles de motif seulement, même quand rien n'a été remplacé.
La tuile Données personnelles remplacées de l'onglet Vue d'ensemble additionne les valeurs remplacées ces dernières 24 heures, et le tableau Protections a une colonne Protection des données personnelles qui montre quelles machines ont la fonction activée.
Limites
- C'est de la détection, pas une garantie. Le modèle échange un peu de rappel contre beaucoup moins de faux positifs sur le code ; des formats inhabituels, des noms dans des contextes inhabituels, ou des données personnelles à l'intérieur du code source peuvent passer. Voyez-y une forte réduction de l'exposition, pas une preuve qu'aucune donnée personnelle n'a atteint le fournisseur.
- Les très grosses requêtes sont en partie traitées par motifs seulement. Le modèle lit au plus 300 000 caractères de texte nouveau par requête, du plus récent au plus ancien ; au-delà de ce budget, seules les règles de motif tournent, et la Chronologie de sécurité enregistre la requête comme « partiel — budget de modèle atteint ; règles de motif seulement ». L'historique plus ancien avait déjà été traité aux tours précédents.
- Seul le texte de la conversation est modifié. Les images, les pièces jointes envoyées comme données binaires, et les champs tels que les identifiants et les noms de modèles ne sont pas analysés.
- Les traces gardent les vraies valeurs. Quand le traçage capture les corps IA, la requête stockée est celle que l'agent a envoyée et la réponse stockée est la réponse restaurée : toutes deux contiennent donc les vraies valeurs — chiffrées sur votre Mac, comme tout corps de trace. La version à substituts que le fournisseur a reçue n'est pas stockée.