Modèles et fournisseurs
Chaque agent de code de Bromure Agentic Coding — Claude Code, Codex, Grok, Kimi et omp — obtient son modèle et ses identifiants d'un seul endroit : le tableau Modèles. Vous enregistrez chaque source une fois (la connexion ou la clé d'API d'un fournisseur cloud, Amazon Bedrock, OpenRouter, votre propre serveur d'inférence, ou des modèles qui tournent sur ce Mac), et chaque machine peut l'utiliser. Une machine (un espace de travail, dans l'éditeur de réglages) hérite par défaut de ces réglages globaux et peut en remplacer n'importe quelle partie.
Ce chapitre couvre le tableau lui-même, la connexion et la déconnexion, le choix des modèles par agent, les remplacements par machine, la façon dont les agents atteignent des fournisseurs qui ne sont pas les leurs, ce qui arrive aux agents en cours quand vous changez quelque chose, et le moteur intégré sur l'appareil : son catalogue, ses téléchargements, ses fenêtres de suivi et les commandes model. Pour la liste champ par champ du panneau de l'espace de travail, voir Réglages des modèles. Fusion — plusieurs modèles qui répondent à un même prompt — est une fonctionnalité distincte, avec son propre panneau.
Remarque : Les versions antérieures avaient un panneau Agents par espace de travail, un panneau Modèles locaux et un mode de routage « hybride » qui basculait du cloud vers un modèle local. Les trois ont disparu. Les choix de modèles et d'identifiants vivent sur le tableau Modèles, et le trafic d'une machine va soit vers le cloud, soit vers un moteur local, agent par agent, comme décrit ci-dessous.
Où apparaît le tableau Modèles
Le même tableau à deux colonnes apparaît à quatre endroits :
| Où | Ce qu'il modifie | Quand les modifications s'appliquent |
|---|---|---|
| Préférences › Modèles (⌘,) | Les réglages globaux dont hérite chaque machine. | Immédiatement — le tableau enregistre au fil de vos modifications, indépendamment du bouton Enregistrer de la fenêtre des Préférences. |
| L'éditeur de réglages d'une machine › Modèles | Le remplacement des réglages globaux propre à cette machine (voir Remplacements par machine). | Quand vous cliquez sur Enregistrer dans l'éditeur. |
| L'étape Modèles de l'assistant d'accueil | Les réglages globaux, au premier lancement uniquement. | Immédiatement. |
| Les Préférences d'un Mac distant reflété (Réglages pour : un hôte distant) | Les réglages globaux de ce Mac, récupérés par le tunnel avec les clés d'API masquées. | Quand vous cliquez sur Enregistrer. Voir Accès à distance. |
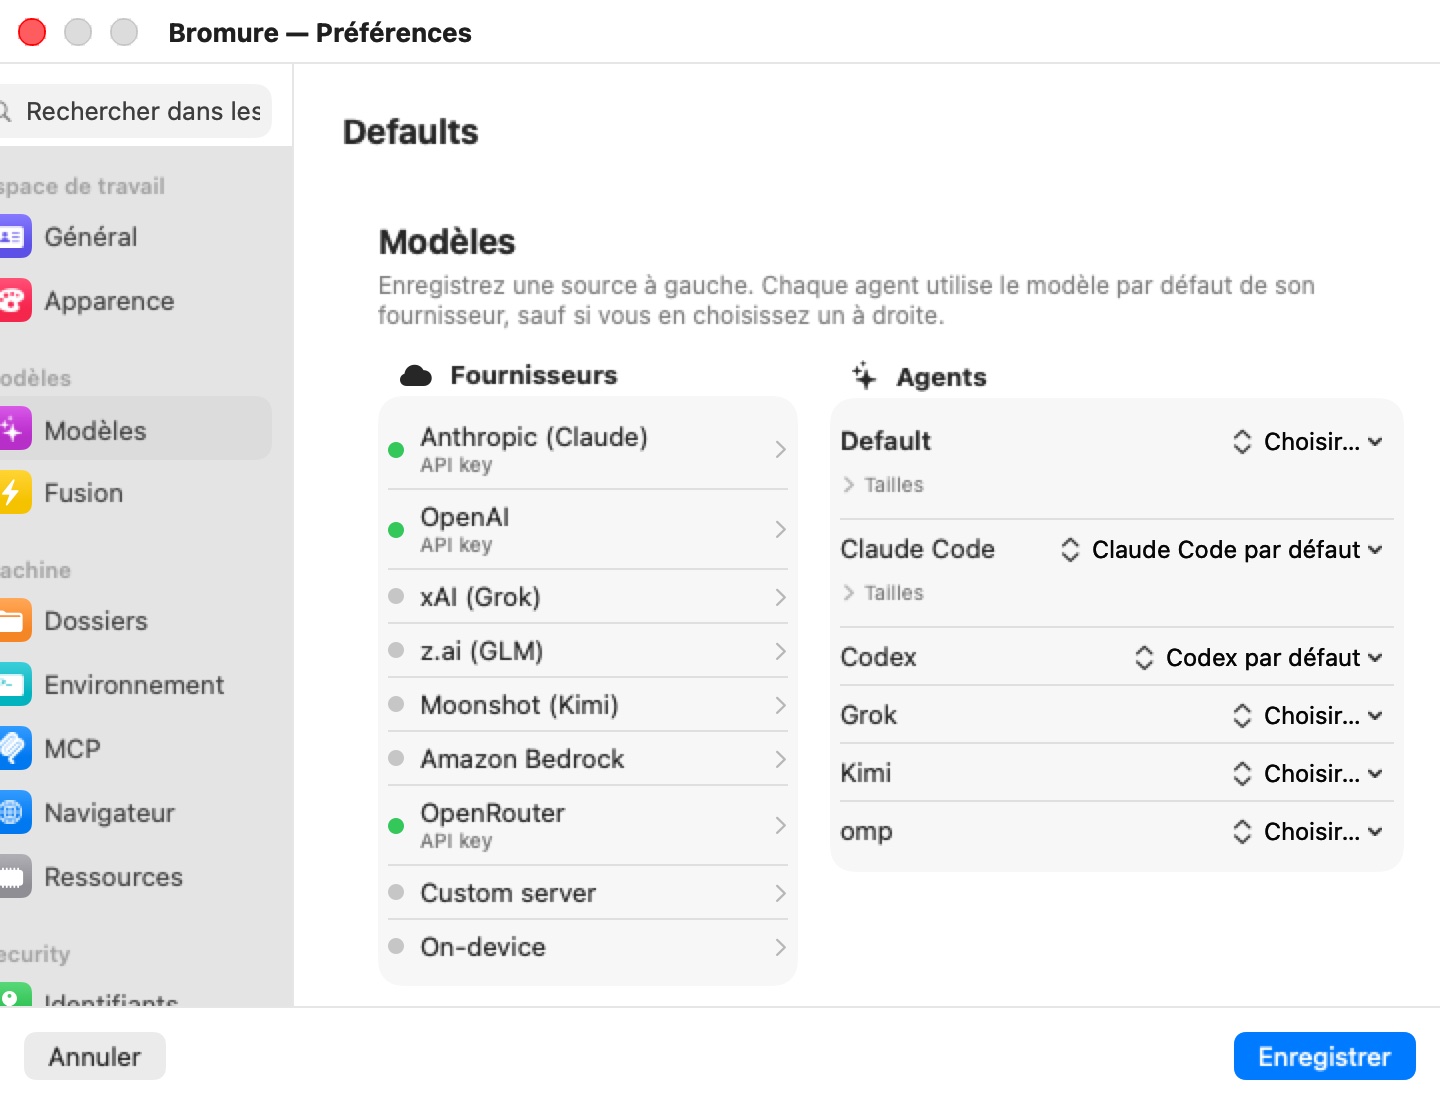
Le panneau s'intitule Modèles, avec la légende « Enregistrez une source à gauche. Chaque agent utilise le modèle par défaut de son fournisseur, sauf si vous en choisissez un à droite. » À gauche se trouve la colonne Fournisseurs ; à droite, la colonne Agents.
Fournisseurs
Chaque ligne de Fournisseurs a un point d'état et un sous-titre d'une ligne. Vert signifie utilisable ; gris, non configuré ; orange, une connexion d'abonnement expirée. Cliquez sur une ligne pour ouvrir sa fenêtre contextuelle de configuration.
| Fournisseur | Comment le configurer | Remarques |
|---|---|---|
| Anthropic (Claude) | Connexion par abonnement ou clé d'API | Fournisseur natif de Claude Code. |
| OpenAI | Connexion par abonnement ou clé d'API | Fournisseur natif de Codex. |
| xAI (Grok) | Connexion par abonnement ou clé d'API | Fournisseur natif de Grok. |
| z.ai (GLM) | Clé d'API uniquement | Le forfait code de z.ai est fourni sous forme de clé d'API ; il n'y a rien à quoi se connecter. |
| Moonshot (Kimi) | Connexion par abonnement ou clé d'API | Fournisseur natif de Kimi. |
| Amazon Bedrock | Utiliser Amazon Bedrock, région facultative et clé d'API facultative | Voir Amazon Bedrock. |
| OpenRouter | Clé d'API uniquement | Sa liste de modèles est récupérée en direct depuis OpenRouter. |
| Serveur personnalisé | URL du serveur et clé d'API facultative | Tout serveur compatible OpenAI. Voir Serveur personnalisé. |
| Sur l'appareil | Télécharger des modèles | Les modèles MLX tournent sur le GPU de ce Mac. Voir Modèles sur l'appareil. |
Le sous-titre de la ligne indique comment un fournisseur est configuré : API key, subscription, connexion expirée, Identifiants AWS (Bedrock), un nom d'hôte (serveur personnalisé) ou N installed (sur l'appareil). Dans le remplacement d'une machine, il peut aussi indiquer inherited API key, inherited subscription, overridden here ou off here.
Connexion et clés d'API
Pour Anthropic, OpenAI, xAI et Moonshot, la fenêtre contextuelle commence par Sign in with fournisseur (« Connexion interactive dans une VM temporaire — aucune clé API nécessaire. »), puis « ou collez une clé API » au-dessus d'un champ Clé API. Sans l'un ni l'autre, elle indique Pas encore configuré.
La connexion exécute la connexion par la CLI du fournisseur dans une VM jetable ; la page du fournisseur s'ouvre dans votre navigateur, et la connexion capturée est stockée sur l'hôte, jamais dans une machine. Une fois connecté, la fenêtre contextuelle affiche Connecté avec l'ancienneté, plus Se reconnecter… et Se déconnecter…. Se déconnecter… demande une confirmation — « Se déconnecter de fournisseur ? », « Les espaces de travail qui utilisent cette connexion cesseront de fonctionner jusqu'à ce que vous vous reconnectiez. » — avec Se déconnecter / Annuler.
Si le fournisseur refuse une connexion enregistrée (par exemple, parce qu'elle a été révoquée ailleurs), la fenêtre contextuelle passe à un panneau orange Connexion expirée qui explique que les sessions ne peuvent plus l'utiliser tant que vous ne vous êtes pas reconnecté, avec un bouton Se reconnecter bien visible.
Une clé d'API collée l'emporte sur un abonnement pour le même fournisseur : saisir une clé bascule ce fournisseur en paiement à l'usage. Les clés sont stockées chiffrées (voir Où les réglages sont stockés).
Remarque : Un abonnement ne peut alimenter que son propre agent — un abonnement Claude fait tourner Claude Code, un abonnement ChatGPT fait tourner Codex, et ainsi de suite. Un fournisseur connecté par abonnement n'apparaît donc jamais dans le menu de modèles d'un autre agent, et ne peut pas être utilisé sur la ligne Default. Les clés d'API n'ont pas cette restriction.
Portée de l'abonnement : toutes les machines ou une seule
Une connexion lancée depuis Préférences › Modèles est toujours partagée par toutes les machines. Une connexion lancée depuis l'éditeur de réglages d'une machine (son panneau Modèles) se termine par une question : Partager avec tous les espaces de travail ? — « Utiliser cette connexion fournisseur pour tous les espaces de travail Bromure (en remplaçant la connexion fournisseur propre à chacun), ou seulement pour celui-ci ? » — avec Tous les espaces de travail et Cet espace de travail uniquement.
- Tous les espaces de travail stocke la connexion comme connexion partagée et supprime toute connexion propre à une machine pour ce fournisseur, pour que la nouvelle connexion soit réellement celle qu'utilise chaque machine.
- Cet espace de travail uniquement la stocke pour cette machine seulement. Une machine qui a sa propre connexion l'utilise toujours de préférence à la connexion partagée.
Quand la connexion a été lancée depuis un Mac distant reflété et que personne ne répond à la question, le choix par défaut est Cet espace de travail uniquement.
Amazon Bedrock
La fenêtre contextuelle de Bedrock explique : « N'importe quel agent peut tourner sur Amazon Bedrock : Claude Code nativement, les autres via l'API compatible OpenAI de Bedrock. Signez les requêtes avec les identifiants AWS propres à chaque espace de travail (Identifiants → AWS), ou collez une clé d'API Bedrock. »
- Activez Utiliser Amazon Bedrock.
- Définissez éventuellement une Région AWS. Laissée vide, chaque machine utilise la région de ses propres identifiants AWS, sinon
us-east-1. - Collez éventuellement une Clé API Bedrock (facultative — sinon les identifiants AWS signent). Sans clé, l'hôte signe chaque requête avec les identifiants AWS de la machine, issus de son panneau Identifiants ; les identifiants n'entrent jamais dans la VM.
Activer Bedrock pré-remplit le modèle principal de Claude Code avec un identifiant de modèle Claude sur Bedrock. Les identifiants de modèles sont ceux qu'utilise Bedrock (par exemple us.anthropic.claude-sonnet-4-6) ; choisissez-les par agent dans le menu ou tapez les vôtres avec Identifiant personnalisé…. Bedrock n'a pas de point de terminaison qui liste les modèles, le menu propose donc une courte liste choisie.
Un agent sur Bedrock sans clé d'API n'est prêt à démarrer que sur les machines qui ont des identifiants AWS. Désactiver Utiliser Amazon Bedrock efface tous les choix de modèles qui pointaient vers Bedrock, et ces agents reviennent à leurs valeurs par défaut.
Serveur personnalisé
Un Serveur personnalisé est n'importe quel serveur d'inférence compatible OpenAI — vLLM, Ollama, LM Studio, llama-server — sur ce Mac ou ailleurs sur votre réseau. La fenêtre contextuelle le dit « Recommended for local models. »
- Activez Activé.
- Saisissez l'URL du serveur (par exemple
http://127.0.0.1:11434/v1) et, si le serveur en demande une, une Clé API (facultative). - Cliquez sur Tester la connexion. En cas de réussite, elle affiche N model(s) et les modèles du serveur apparaissent dans le menu de chaque agent sous Serveur personnalisé ; en cas d'échec, elle affiche l'erreur du serveur.
Avec un serveur personnalisé, l'identifiant de modèle est celui du serveur, tel quel (par exemple qwen3:32b). Le proxy de réparation de l'hôte traduit le format de fil de chaque agent (messages Anthropic, chat OpenAI, responses OpenAI) vers le /v1/chat/completions du serveur et retour, et la fenêtre de contexte du modèle, sa prise en charge de la vision et du raisonnement sont sondées auprès du serveur et transmises aux agents. Aucun processus de moteur n'est lancé sur le Mac pour un serveur personnalisé.
Modèles sur l'appareil
Sur l'appareil ouvre une liste de modèles du catalogue — « MLX models run in-process on this Mac (N GB) — the lazy backup, nothing to install. » Chaque ligne affiche le nom du modèle, un badge d'adéquation (Fits, Tight ou Won't fit), sa taille de téléchargement, et une action :
| Contrôle | Signification |
|---|---|
| Obtenir | Télécharge le modèle. Désactivé quand il ne tient pas sur ce Mac. |
| Barre de progression + ✕ | Téléchargement en cours ; ✕ l'annule et supprime le téléchargement partiel. |
| Reprendre | Un téléchargement interrompu (l'application s'est fermée ou a planté) ; reprend là où il s'était arrêté. |
| Réessayer | Le téléchargement a échoué ; survolez pour voir la raison. |
| Supprimer | Installé ; supprime les poids et efface tout choix de modèle qui les utilisait. |
Les modèles installés apparaissent dans le menu de chaque agent sous Sur l'appareil. Les téléchargements sont partagés par toutes les machines. Le catalogue, les règles d'adéquation et le moteur sont décrits dans Le moteur sur l'appareil.
Agents : choisir les modèles
La colonne Agents a une ligne Default, puis une ligne par agent : Claude Code, Codex, Grok, Kimi et omp. Chaque ligne a une puce de modèle ; cliquez dessus pour choisir.
Ce qu'affiche une puce :
- Agent default — rien n'est choisi et le fournisseur propre à l'agent est configuré ; l'agent utilise donc le modèle par défaut de ce fournisseur, exactement comme le ferait son propre « Default » de
/model. Vous n'avez rien à choisir. - Choisir… — rien n'est choisi et rien ne se résout pour cet agent.
- Un identifiant de modèle, avec un point de couleur indiquant sa source (bleu : un fournisseur cloud ; menthe : le serveur personnalisé ; violet : sur l'appareil ; orange, barré et suivi de · indisponible : un fournisseur que cet agent ne peut pas atteindre — voir Quel agent peut atteindre quel fournisseur). · hérité après l'identifiant signifie que la valeur vient de la ligne Default (ou, dans le remplacement d'une machine, des réglages globaux). Un ✕ à côté d'un choix explicite l'efface.
Le menu de la puce liste chaque fournisseur utilisable que l'agent peut atteindre, sous forme de sous-menu d'identifiants de modèles (une liste choisie, fusionnée avec la liste de modèles en direct du fournisseur quand il y en a une), puis Serveur personnalisé et Sur l'appareil quand ils sont configurés. Chaque sous-menu de fournisseur se termine par Identifiant personnalisé…, qui demande « The id exactly as the backend names it (e.g. claude-opus-5, glm-4.6, qwen3-coder). » Pour un agent ayant un choix explicite, le menu propose aussi Utiliser la valeur par défaut (ou Use agent’s default quand rien n'est défini sur la ligne Default) pour l'effacer.
Si le menu n'a rien à proposer, il le dit : Configurez d'abord un fournisseur ; No configured provider can power agent quand les fournisseurs configurés sont tous hors de portée de cet agent ; ou Un abonnement ne peut alimenter que son propre agent quand les seuls fournisseurs configurés sont des abonnements d'autres agents. Sous Serveur personnalisé, Testez la connexion pour lister les modèles signifie que le serveur n'a pas encore été sondé.
La ligne Default
Un modèle sur la ligne Default s'applique à chaque agent qui n'a pas de choix propre — y compris les agents dont le propre fournisseur est configuré et qui utiliseraient sinon le modèle par défaut de leur fournisseur. Laissez Default sur Choisir… si vous voulez que chaque agent utilise le modèle par défaut de son propre fournisseur.
Tailles
Claude Code utilise trois emplacements de modèle ; tous les autres agents utilisent un seul modèle. Les lignes Default et Claude Code ont une section Tailles avec deux puces supplémentaires :
| Taille | Emplacement Claude Code |
|---|---|
| Large | ≈ opus |
| (puce principale) | ≈ sonnet |
| Small | ≈ haiku (tâches d'arrière-plan et rapides) |
Non définis, les emplacements large et petit suivent les valeurs par défaut de Claude Code. Tailles s'ouvre d'elle-même quand l'un d'eux est défini. Sur la ligne Claude Code, Rétablir les valeurs par défaut abandonne tous les choix propres à Claude Code pour qu'il hérite de nouveau de la ligne Default. Codex, Grok, Kimi et omp n'utilisent que la puce principale.
Quel agent peut atteindre quel fournisseur
Chaque agent atteint nativement son propre fournisseur. Il peut aussi être dirigé vers certains autres fournisseurs, que l'hôte relie pour lui :
| Agent | Fournisseur natif | Atteint aussi |
|---|---|---|
| Claude Code | Anthropic (abonnement ou clé) | Amazon Bedrock (le mode Bedrock propre à Claude Code) ; OpenRouter et z.ai (directement, via leurs points de terminaison compatibles Anthropic, clé d'API) ; serveur personnalisé ; sur l'appareil |
| Codex | OpenAI | Amazon Bedrock, OpenRouter, xAI, Moonshot (via le proxy de réparation de l'hôte, clé d'API) ; serveur personnalisé ; sur l'appareil |
| Grok | xAI | Amazon Bedrock, OpenRouter, Moonshot (proxy de réparation) ; serveur personnalisé ; sur l'appareil |
| Kimi | Moonshot | Amazon Bedrock, OpenRouter, xAI (proxy de réparation) ; serveur personnalisé ; sur l'appareil |
| omp | Anthropic, clé d'API uniquement | Amazon Bedrock, OpenRouter, xAI, Moonshot (proxy de réparation) ; z.ai quand omp lui-même y est basculé ; serveur personnalisé ; sur l'appareil |
Avec le proxy de réparation, l'agent dans la VM parle à l'hôte, qui traduit le format de fil de l'agent, détient la vraie clé (ou signe pour Bedrock) et transmet la requête. La clé n'entre jamais dans la VM. Les routes OpenRouter et z.ai de Claude Code font plutôt pointer l'agent directement vers le point de terminaison compatible Anthropic du fournisseur (https://openrouter.ai/api, https://api.z.ai/api/anthropic), avec une clé de substitution que l'hôte remplace par la vraie sur le fil, comme pour tout identifiant cloud (voir Identifiants et la frontière du fil).
Le menu de modèles d'un agent ne propose que les fournisseurs qu'il peut atteindre. Claude Code ne parle que le dialecte Anthropic, son menu n'a donc pas de modèles OpenAI, xAI ou Moonshot ; l'API compatible OpenAI de z.ai n'est pas de celles vers lesquelles les autres agents peuvent être reliés, si bien que le menu de Claude Code est le seul menu d'agent à proposer des modèles z.ai (omp basculé vers z.ai l'atteint par lui-même).
Un choix enregistré avant de devenir inaccessible — ou hérité de la ligne Default par un agent qui ne peut pas l'utiliser — s'affiche en orange, barré, suivi de · indisponible. Son infobulle explique : « Agent can’t use provider models, so it runs on its own provider instead. Pick another model. »
omp n'a pas de fournisseur propre sur le tableau et ne peut pas utiliser d'abonnement ; donnez-lui un fournisseur à clé d'API.
Remplacements par machine
L'éditeur de réglages d'une machine a un panneau Modèles (dans le groupe Modèles). Par défaut, il affiche un interrupteur, Réglages de modèles personnalisés pour cet espace de travail, désactivé — « Inheriting the global settings (Preferences → Models). » — et un résumé Modèles hérités : les modèles globaux Large / Medium / Small et les fournisseurs configurés.
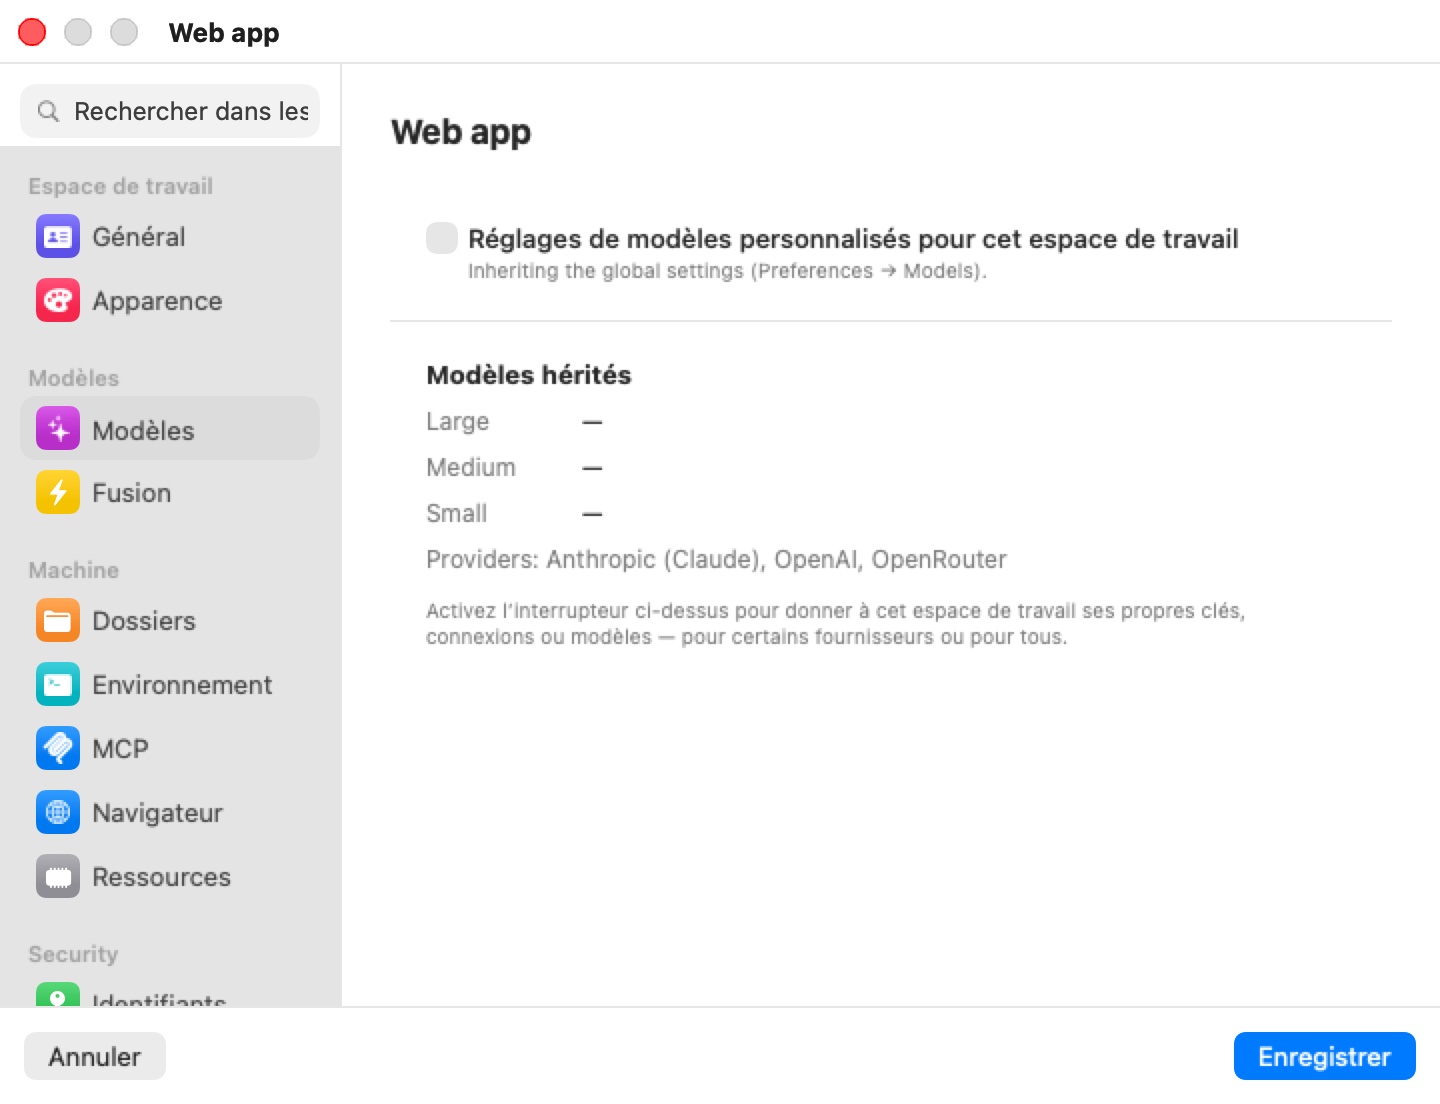
Activez l'interrupteur et choisissez l'un de deux modes :
- Hériter, avec modifications (par défaut) — « Starts from the global settings; only what you set below is different here. » Le tableau complet apparaît, montrant les réglages globaux avec les modifications de cette machine par-dessus. Tout ce que vous ne touchez pas continue de suivre les réglages globaux en direct — un fournisseur que vous enregistrez plus tard globalement apparaît ici aussi.
- Autonome — « This workspace has its own providers, logins and model choices below — the global settings are ignored. » Passer en Autonome part d'une copie de ce qui est actuellement en vigueur, si bien que rien ne change tant que vous ne modifiez rien.
En mode Hériter, avec modifications, chaque fenêtre contextuelle de fournisseur indique d'où vient le fournisseur et vous permet de changer cela pour cette machine seulement :
| Libellé | Signification |
|---|---|
| Inherited from Preferences → Models (API key / subscription / AWS credentials). | L'identifiant global est utilisé. Ne pas utiliser dans cet espace de travail permet de s'en retirer, « — or override it below » avec la clé ou la connexion propre à cette machine. |
| Not used in this workspace — the global settings have it. | Vous vous en êtes retiré. Utiliser le fournisseur global vous y réinscrit. |
| This workspace's own credential. | Cette machine a sa propre clé ou connexion. Utiliser le fournisseur global l'abandonne. |
| This workspace's own server. / Utiliser le serveur global | Idem pour le serveur personnalisé. |
Les puces de modèles fonctionnent comme sur le tableau global ; une puce inchangée affiche · hérité, et effacer un choix explicite la ramène à la valeur globale (Utiliser le réglage global).
Le remplacement est enregistré avec la machine quand vous cliquez sur Enregistrer. Les clés saisies dans un remplacement sont stockées chiffrées avec les autres secrets de la machine.
Changer les modèles sur des machines en marche
Vous n'avez jamais besoin de redémarrer une machine pour un changement de modèle ou d'identifiant. Quand vous enregistrez un fournisseur, collez ou modifiez une clé, vous connectez ou vous déconnectez, faites passer un agent à un autre modèle, ou enregistrez le remplacement d'une machine :
- L'hôte met à jour ce que lisent les agents de la machine — la table de substitution des identifiants, l'environnement et les fichiers de configuration des agents — pour chaque machine en marche.
- Chaque agent dont les identifiants ou le modèle ont réellement changé est arrêté dans son onglet et relancé immédiatement avec ses options de reprise, si bien que la conversation continue. Dans la vue chat, la session garde sa transcription ; dans un terminal, vous voyez l'agent quitter puis revenir aussitôt.
- Les agents dont la configuration n'a pas changé ne sont pas touchés, et la VM elle-même ne redémarre jamais.
- La configuration Fusion de la machine suit les mêmes réglages : ses branches et son juge sont réévalués, et le bouton ⚡ est désengagé s'il reste moins de deux modèles utilisables.
Les modifications sur le tableau global s'appliquent environ une seconde et demie après que vous avez cessé de taper.
Avertissement : Redémarrer un agent interrompt ce qu'il faisait à ce moment-là. Si un agent est au milieu d'un long tour, attendez qu'il termine avant de changer son modèle ou ses identifiants.
Où les réglages sont stockés
Les réglages globaux sont conservés dans ~/Library/Application Support/BromureAC/models.enc, chiffrés avec la même clé que le coffre des secrets des espaces de travail. Le remplacement d'une machine est stocké avec la machine, ses clés dans le magasin de secrets chiffré. Les connexions d'abonnement sont conservées côté hôte par le proxy d'identifiants, partagées ou propres à une machine selon le choix ci-dessus. Aucun de ces secrets n'est jamais copié dans une VM : les agents reçoivent des valeurs de substitution que l'hôte remplace sur le fil.
Limites
- Les abonnements ne sont disponibles que pour Anthropic, OpenAI, xAI et Moonshot, et chacun n'alimente que son propre agent.
- omp n'utilise que des clés d'API.
- Un serveur personnalisé doit être compatible OpenAI.
- Au sein d'une machine, tous les agents qui tournent en local (serveur personnalisé ou sur l'appareil) partagent un seul modèle local : le choix de l'agent principal l'emporte.
- Le moteur sur l'appareil utilise l'unique GPU du Mac et exécute une génération à la fois.
- Le tableau Modèles n'est pas disponible dans Bromure Remote sur iPhone, iPad ou Apple Vision Pro ; modifiez les modèles depuis un Mac.
Le moteur sur l'appareil
Le moteur sur l'appareil exécute des modèles de code à poids ouverts sur le GPU de votre Mac avec le framework MLX d'Apple — pas d'aller-retour vers le cloud, pas de facturation au jeton, et aucun code qui quitte le Mac. Il n'y a rien à installer, pas d'environnement Python ni de serveur à configurer.
Remarque : L'inférence tourne sur le Mac, pas dans la VM. Le périphérique graphique Metal optionnel du navigateur ne fournit à Linux ni calcul GPU ni accès à MLX ; l'invité atteint donc le moteur en traversant la frontière du fil. Apple Silicon est requis — la même exigence que pour l'application elle-même.
Le processus du moteur
Le moteur MLX tourne comme processus enfant supervisé du propre binaire de l'application (bromure-ac model _mlx-engine), pas dans l'application. Charger un modèle trop gros pour la mémoire du Mac ne tue que le processus enfant du moteur, jamais l'application ni ses VM en marche. L'application redémarre automatiquement un moteur qui a planté, jusqu'à trois fois ; ensuite, elle abandonne avec la ligne de journal engine child crashed repeatedly — giving up (a model likely OOMs this Mac). Le processus enfant est tué quand l'application quitte, et un orphelin laissé par un plantage brutal est nettoyé au lancement suivant.
Un seul moteur sert toutes les machines. Il se lie à un port de boucle locale attribué par le noyau sur 127.0.0.1 — jamais 0.0.0.0, et jamais le 11434 habituel d'Ollama, si bien qu'une installation Ollama ou LM Studio séparée continue de fonctionner. Il peut garder plusieurs modèles dans un budget mémoire (la mémoire unifiée du Mac moins une marge), en chargeant chacun à sa première utilisation et en évinçant le moins récemment utilisé quand la mémoire se fait rare.
Pendant que le moteur se prépare, la barre d'outils d'une machine affiche un petit badge processeur avec une roue (« Starting local engine… ») ; il passe au vert une fois le modèle prêt, ou à l'orange si le moteur n'a pas pu démarrer (survolez-le pour voir la raison).
Comment l'invité l'atteint
Les agents de la VM ne parlent jamais directement au moteur. Ils ciblent l'hôte synthétique https://bromure.llm, qui n'a pas de vrai DNS : le proxy côté hôte l'intercepte, applique la même analyse d'injection de prompt et la même capture de trace que pour le trafic cloud, et transmet la requête au moteur. L'inférence locale n'est jamais un angle mort.
Les agents sont configurés avec le vrai identifiant de modèle que sert le moteur (par exemple mlx-community/Qwen3-8B-4bit-DWQ), si bien que leur dimensionnement du contexte et leurs recherches de capacités voient la réalité.
Remarque : Un modèle dont le moteur MLX ne prend pas encore en charge l'architecture échoue avec une erreur claire et permanente — « its architecture … isn't supported by the on-device engine yet — pick a different model » — renvoyée comme erreur client pour que l'agent ne réessaie pas en boucle. Utilisez un serveur personnalisé pour ces modèles.
Le catalogue
Le catalogue est une liste choisie de modèles MLX pré-convertis, chacun vérifié pour ce qui compte le plus dans le code agentique — des appels d'outils fiables — et chacun accompagné d'une taille de téléchargement et d'une quantité minimale de mémoire unifiée.
Un catalogue de base est livré dans l'application, pour que la liste fonctionne hors ligne dès le premier jour. L'application récupère un catalogue actualisé sur https://dl.bromure.io/mlx/catalog.json ; un catalogue publié plus récent remplace le catalogue de base au lieu de fusionner avec lui. Un modèle retiré du catalogue publié disparaît de la liste, sauf si vous l'avez déjà installé.
Le catalogue intégré contient quatre modèles Qwen3, tous vérifiés pour les appels d'outils :
| Modèle | Téléchargement | Mémoire unifiée minimale | Recommandé |
|---|---|---|---|
| Qwen3 8B (4-bit DWQ MLX) | 4.3 GB | 16 GB | Oui |
| Qwen3-Coder 30B-A3B (4-bit DWQ MLX) | 17 GB | 32 GB | Oui |
| Qwen3-Coder-Next 80B-A3B (mxfp4 MLX) | 42 GB | 96 GB | Oui |
| Qwen3-Coder 480B-A35B (4-bit MLX) | 270 GB | 512 GB | Non |
Un catalogue actualisé peut ajouter des versions plus récentes ou plus grosses sans mise à jour de l'application.
Le badge d'adéquation
Chaque modèle est évalué par rapport à la mémoire unifiée de votre Mac :
- Won't fit — le minimum du modèle dépasse votre mémoire. La ligne est grisée et ne peut pas être téléchargée.
- Tight — il se charge, avec moins de 16 GB de reste pour tout le reste.
- Fits — le minimum plus 16 GB de marge tiennent.
Par exemple, Qwen3 8B (16 GB minimum) affiche Tight sur un Mac de 16 GB et Fits à partir de 32 GB.
Téléchargements et stockage
Les poids viennent directement de huggingface.co via un téléchargeur intégré — pas de Python ni de conversion. Chaque fichier de poids est écrit en continu dans un fichier .partial temporaire et renommé en place une fois complet ; un téléchargement interrompu reprend fichier par fichier, et un téléchargement partiel n'est jamais pris pour un modèle installé. La documentation, les images et les fichiers GGUF du dépôt sont ignorés. Une vérification de l'espace disque passe en premier et échoue vite plutôt que de remplir votre disque :
Not enough disk space: 40 GB free, but about 270 GB is needed.
Les modèles sont stockés par dépôt sous :
~/Library/Application Support/BromureAC/models/<org>--<name>/
Les modèles déjà mis en cache par d'autres outils dans ~/.cache/huggingface/hub sont migrés une fois dans ce répertoire, via des liens physiques, si bien que rien n'est téléchargé deux fois.
Tout dépôt Hugging Face déjà au format MLX peut aussi être récupéré par son nom org/repo en ligne de commande (voir Référence en ligne de commande) ; un tel modèle n'est pas testé — aucune garantie sur les appels d'outils ni sur la mémoire. Les dépôts GGUF sont refusés, car GGUF est le format d'Ollama et de llama.cpp, pas de MLX :
That's a GGUF (Ollama/llama.cpp) model — Bromure serves MLX weights only.
Diffusion en continu, réflexion et vision
Les tours locaux s'affichent jeton par jeton, pour le moteur sur l'appareil comme pour un serveur personnalisé. Le proxy relaie le texte au fur et à mesure de sa génération en retenant juste assez de la fin pour retirer un appel d'outil ayant fui, puis termine le tour avec le résultat réparé.
Les modèles de raisonnement diffusent leur réflexion sous forme de blocs de réflexion natifs sur tous les formats de fil, si bien que les agents l'affichent comme ils affichent la réflexion d'un modèle cloud ; la réflexion n'est pas réinjectée dans la transcription. Les modèles capables de vision (sondés auprès d'un serveur personnalisé, ou signalés dans le catalogue) acceptent des images : le proxy traduit les blocs d'image entre les formats de fil.
Remarque : Le premier tour d'une session paie le pré-remplissage par le modèle de tout le prompt de l'agent — souvent des dizaines de milliers de jetons de prompt système et de schémas d'outils — avant que le premier jeton n'apparaisse. Sur un modèle 8B, cela peut prendre une minute ou plus ; les tours suivants réutilisent le cache du moteur et démarrent presque immédiatement.
Réparation des appels d'outils
Les modèles quantifiés émettent souvent un appel d'outil sous forme de texte brut au lieu d'un appel structuré. Un proxy de réparation placé devant chaque moteur local — sur l'appareil ou serveur personnalisé — met chaque réponse en tampon et reconnaît les nombreuses formes que peut prendre un appel qui a fui, par exemple :
<function name="write_file" arguments='{…}'>
<tool_call>{…}</tool_call>
[{"name": "…", "parameters": {…}}]
ainsi que le format natif de Qwen3-Coder <function=Name><parameter=k>v</parameter></function> et le format à canaux de Gemma. Il transforme ce qu'il trouve en véritables appels d'outils dans le format de fil propre à l'agent. Il détecte aussi un modèle qui annonce une action (« Now I'll create the file: ») puis s'arrête sans appeler l'outil, et relance jusqu'à deux fois pour récupérer l'appel. La réparation est toujours active pour l'inférence locale.
Les problèmes du moteur reviennent à l'agent sous forme d'erreurs lisibles dans son propre format de fil, par exemple :
Local inference engine unreachable (starting up, reloading a model, or stopped) — retry in a moment.
Performances attendues
- Le débit dépend du modèle et de la puce. Un petit modèle comme Qwen3 8B est vif sur n'importe quel Mac pris en charge ; les grosses versions à mélange d'experts sont plus lentes et demandent beaucoup plus de mémoire. La fenêtre Métriques d'inférence montre les débits réels sur votre matériel.
- La première requête paie le chargement du modèle en mémoire.
- Les tours suivants coûtent moins. Le moteur garde un cache de prompt par conversation, si bien que chaque tour d'agent ne traite que les nouveaux jetons.
- La génération est sérialisée. Le moteur exécute une génération à la fois ; plusieurs sessions actives se partagent le GPU au lieu de tourner en parallèle.
Suivre l'inférence locale
Deux fenêtres du menu Fenêtre vous permettent de suivre l'inférence locale sans Console.app.
Métriques d'inférence
Fenêtre › Métriques d'inférence… ouvre une fenêtre de télémétrie en direct (Métriques d'inférence) avec un onglet par moteur utilisé — le moteur intégré plus chaque serveur personnalisé vers lequel pointent vos machines. L'onglet du moteur intégré, intitulé Local inference avec l'adresse de boucle locale du moteur, affiche des cartes Decode tok/s, Prefill tok/s, Running, Waiting, In flight, Avg latency, Cache hit, Metal mem, Gen tokens et Prompt tokens, une liste Modèles chargés, et une section repliable All metrics avec le tableau brut.
La fenêtre interroge le moteur toutes les 5 secondes, seulement pendant qu'elle est ouverte. Les débits de décodage et de pré-remplissage sont des moyennes sur toute la durée de vie, ils restent donc stables. Quand le moteur est arrêté, la fenêtre affiche engine not reachable ; pendant une longue génération, elle peut brièvement afficher engine busy (timed out). Les serveurs personnalisés qui n'exposent pas de point de terminaison de métriques (Ollama, par exemple) ont quand même des cartes, mesurées par le proxy à partir du trafic qu'il relaie.
Journal du moteur d'inférence
Fenêtre › Journal du moteur d'inférence… ouvre un suivi en direct (Journal du moteur d'inférence) de la sortie du moteur et de ses événements de cycle de vie — chargements de modèles, « serving », statistiques par requête, et tout manque de mémoire, plantage, redémarrage ou erreur de chargement. Les lignes sont colorées (rouge pour les échecs, vert pour les événements sains, orange pour les avertissements, bleu pour le travail en cours). La barre d'outils comporte un champ Filtrer…, une case Défilement auto, Copier et Effacer ; tant que rien n'est journalisé, elle indique No inference-engine activity yet. Le tampon garde les 5 000 dernières lignes, et chaque ligne est aussi écrite sur la sortie d'erreur standard de l'application.
Astuce : Si un modèle local semble lent ou bloqué, ouvrez d'abord le Journal du moteur d'inférence : chargements de modèles, évictions, redémarrages pour manque de mémoire et erreurs d'architecture non prise en charge y apparaissent tous en clair.
Référence en ligne de commande
Les commandes model gèrent les modèles sur l'appareil ; elles communiquent avec l'application en marche. Les commandes qui agissent sur une machine prennent un argument final <vm> : un identifiant de VM ou un nom d'espace de travail. Voir CLI, API et MCP pour l'ensemble des commandes.
bromure-cli model catalog [--all] [--offline]
bromure-cli model pull <catalog-id | org/repo>
bromure-cli model ls
bromure-cli model use <catalog-id | org/repo> <vm>
bromure-cli model rm <catalog-id | org/repo>
bromure-cli vm routing cloud|local <vm>
| Commande | Ce qu'elle fait |
|---|---|
model catalog | Liste les modèles du catalogue avec les badges d'adéquation et d'appels d'outils et une coche pour les modèles installés, et affiche la mémoire unifiée de votre Mac. Actualise d'abord le catalogue publié (sans erreur bloquante en cas d'échec). --all inclut les modèles qui ne tiennent pas ; --offline n'utilise que le catalogue intégré et celui en cache. |
model pull | Télécharge un modèle par identifiant de catalogue ou n'importe quel dépôt Hugging Face MLX, après avoir vérifié qu'il est au format MLX (pas GGUF) et qu'il y a assez d'espace disque, avec une barre de progression. |
model ls | Liste les modèles installés avec leur occupation disque. |
model use | Définit le modèle local qu'utilisent les agents d'une machine en marche, sans redémarrer les agents. Sur une machine qui utilise un serveur personnalisé, n'importe quel identifiant accepté par le serveur fonctionne. |
model rm | Supprime les poids d'un modèle installé. |
vm routing | Bascule une machine en marche entre le routage cloud et le routage local. |
model use et vm routing sont des ajustements à chaud pour une machine en marche ; c'est sur le tableau Modèles que se configurent les modèles d'une machine, et c'est lui qui s'applique au prochain démarrage de la machine.
Commandes de diagnostic internes
Ces sous-commandes cachées existent pour le développement et le dépannage.
| Commande | Objectif |
|---|---|
bromure-cli model _mlx-serve <repo> | Démarre le serveur MLX pour un modèle et reste bloqué, en affichant son port et sa clé pour des tests avec curl. |
bromure-cli model _mlx-selftest <repo> | Charge un modèle, génère une fois, et affiche le temps jusqu'au premier jeton et la vitesse de décodage. |
bromure-cli model _repair-serve --engine-port <port> | Exécute le proxy de réparation des appels d'outils seul, face à un moteur en marche. |
bromure-cli model _tc-test <path> | Exécute la récupération des appels d'outils sur un fichier texte enregistré. |
bromure-cli model _spec-bench <main-repo> --draft <draft-repo> | Compare le décodage spéculatif désactivé et activé pour une paire de modèles. |